무료 요금제에 적용되는 GPT-6와 Intelligent UI 활용법

ChatGPT 무료(Free)와 Go 요금제에서도 GPT-6 Luna와 Intelligent UI를 쓸 수 있게 됩니다. OpenAI는 2026년 10월 7일(미국 기준) 발표에서 Free·Go 요금제는 다음 날인 2026년 10월 8일(미국 기준)부터 순차 적용한다고 밝혔고, 한국 시간 기준 시작 시각은 따로 공개하지 않았습니다. 계정마다 적용 시점이 다를 수 있으니, Chat 탭에서 개념 설명이나 계산 도구를 요청해 보고 나온 결과는 교재와 손계산으로 검산하는 습관부터 들이는 것이 좋습니다(OpenAI 발표, ChatGPT 릴리스 노트).

유료 요금제(Plus, Pro, Business, Enterprise)는 2026년 10월 7일(미국 기준)부터 Chat 탭에서 전 세계 순차 롤아웃을 시작했고, Enterprise는 워크스페이스 관리자 설정에 따라 달라집니다. OpenAI는 ChatGPT 주간 이용자를 12억 명 이상이라고 밝혔습니다(OpenAI 발표).

요금제별 모델과 기능

유료 요금제에는 GPT-6 Sol, Free와 Go 요금제에는 GPT-6 Luna가 적용됩니다. 두 모델 모두 일상 대화용으로 조정되었습니다(OpenAI 발표, ChatGPT 릴리스 노트).

Intelligent UI는 Instant부터 Extra High 추론까지 사용할 수 있습니다. 다만 Pro 추론 옵션은 계속 GPT-6 Astra를 쓰며 Intelligent UI를 지원하지 않습니다. Work와 Codex 모델은 이번 릴리스로 바뀌지 않았고, Enterprise는 워크스페이스 관리자 설정에 따라 달라집니다(ChatGPT 릴리스 노트).

요금제 적용 모델 Intelligent UI 롤아웃 현황
Free, Go GPT-6 Luna 지원(순차 적용) 2026년 10월 8일(미국 기준)부터 순차 확대
Plus, Pro, Business GPT-6 Sol 지원(Pro 추론 옵션은 GPT-6 Astra를 쓰며 미지원) 2026년 10월 7일(미국 기준)부터 전 세계 순차 롤아웃
Enterprise GPT-6 Sol 워크스페이스 관리자 설정에 따름 2026년 10월 7일(미국 기준)부터, 관리자 설정에 따름

릴리스 노트는 Intelligent UI를 Instant부터 Extra High 추론까지 쓸 수 있다고 적었지만, 요금제별로 고를 수 있는 추론 단계는 밝히지 않았습니다(ChatGPT 릴리스 노트).

Intelligent UI란

Intelligent UI는 질문에 맞춰 텍스트, 시각 자료, 상호작용 요소를 함께 보여 주는 인터페이스입니다. 비교 내용은 나란히 배치하고, 설명은 상호작용 도표로 제시하며, 글이 더 알맞은 질문에는 텍스트로 답합니다(OpenAI 발표).

OpenAI는 중심극한정리, 몬티 홀 문제, GDP 같은 학습 주제를 예시로 들었습니다. 입력값을 바꾸거나 단계를 따라가며 개념을 살펴볼 수 있습니다. 저축 계산기, 더치페이 계산기, 게임을 요청하면 대화 안에서 바로 쓰는 도구를 만들 수도 있습니다(OpenAI 발표).

답변을 완성하는 동안에도 먼저 내용을 쓰기 시작하고, 생각이나 도구 사용을 이어 가며 추가 프롬프트 없이 내용을 덧붙입니다. 웹 검색이 필요한 질문에서는 GPT-6 Instant가 GPT-5.6 Instant보다 평균 44% 빨리 답을 시작한다고 OpenAI가 밝혔습니다. 다만 이 수치가 요금제별 모델(Sol·Luna) 중 어느 쪽 기준인지는 따로 적지 않았습니다(OpenAI 발표).

수업과 가정학습에 쓰는 5단계

  1. 개념 설명을 요청할 때 “조작 가능한 도표”나 “단계별 탐색 화면”으로 정리해 달라고 지정합니다. 몬티 홀 문제라면 문을 고르는 과정을, 중심극한정리라면 표본 크기를 바꿔 보는 화면을 요청할 수 있습니다.
  2. 화면에 입력 폼이 나타나면 학생이 값을 바꾸기 전에 결과를 예상하게 합니다. 그다음 실제 결과와 비교합니다.
  3. 수학이나 경제 단원에서는 저축 계산기처럼 필요한 도구를 대화 안에 만들어 보라고 요청합니다.
  4. 계산 결과와 도표를 교과서 공식이나 문제집 정답과 대조합니다.
  5. 시각 요소가 내용을 더 분명하게 만들었는지 확인합니다. 글이 더 알맞다면 일반 텍스트로 다시 요청합니다.

바로 입력해 볼 질문 예시

아래 질문은 OpenAI 발표가 예로 든 주제(몬티 홀, 중심극한정리, 저축 계산기, GDP)를 바탕으로 이 글에서 만든 예시입니다(OpenAI 발표).

  • 「몬티 홀 문제를 문 3개 중 하나를 직접 골라 보는 화면으로 설명해 줘. 선택을 바꿨을 때와 유지했을 때 이길 확률도 비교해 줘.」
  • 「중학생도 이해할 수 있게 중심극한정리를 설명해 줘. 표본 크기를 바꾸면 평균의 분포가 어떻게 달라지는지 직접 조절해 볼 수 있게 해 줘.」
  • 「월 저축액, 연 이율, 기간을 바꿔 볼 수 있는 저축 계산기를 만들어 줘. 계산에 쓴 공식도 함께 보여 줘.」
  • 「GDP를 초등학생 눈높이로 설명해 줘. 그림이 필요 없으면 짧은 글로만 답해 줘.」

Intelligent UI는 답의 형식을 스스로 고르고, 글이 더 알맞으면 텍스트로만 답합니다. 그래서 같은 질문에도 화면이 나오지 않을 수 있습니다(ChatGPT 릴리스 노트).

검증 습관 체크리스트

  • 숫자, 공식, 출처는 교재와 공식 자료로 따로 확인합니다.
  • 계산 도구는 이미 아는 예제를 손으로 계산해 결과가 맞는지 검산합니다.
  • 순차 롤아웃 중에는 같은 교실에서도 계정마다 보이는 기능이 다를 수 있습니다.
  • OpenAI도 모델의 디자인 판단을 개선할 작업이 남아 있다고 밝혔습니다. 화면이 자연스러워 보여도 내용이 맞는지 확인합니다(OpenAI 발표).
  • 모델이 능력 한계나 정보와 도구 부족을 알리도록 훈련되었다는 안내가 있어도, 수업에서는 필요한 교재 확인을 직접 진행합니다(OpenAI 발표).

학원과 교사가 확인할 세 가지

  • 무료 계정(Luna)으로 수업에 필요한 답이 나오나요? 유료 계정(Sol)을 검토하기 전에 같은 질문을 두 계정에서 직접 비교해 보세요.
  • 원내 학생과 교사 계정에 기능이 실제로 활성화되었나요? 순차 롤아웃 중이므로 계정별로 확인해야 합니다.
  • 생성된 계산과 설명을 교사가 먼저 검토하고, 교과서와 대조할 절차가 마련되어 있나요?

마무리

GPT-6와 Intelligent UI는 무료 요금제에도 순차적으로 적용됩니다. 기능이 보인다고 해서 모든 결과를 바로 수업에 쓰기보다, 입력값을 바꿔 보고 공식과 손계산으로 확인하는 절차를 함께 두는 편이 안전합니다.

참고한 공식 자료

AI 에이전트 8종 비교: 학원이 고를 때 볼 기준

2026년 10월 11일 기준 한국 학원이 바로 써 볼 수 있는 AI 에이전트는 직접 설치하는 오픈소스 3종(Hermes Agent·OpenClaw·Block Buzz)과, 유료 요금제에 포함된 Gemini Spark(AI Ultra)·Grok Bot입니다. Meta Muse는 미국·캐나다에서만 제공되고, Hark Handoff는 한국 제공 공지가 없으며, OpenAI dots는 대상 시장의 Pro·Business Premium 구독자에게만 열려 있습니다. dots와 Gemini Spark는 만 18세 이상만 쓸 수 있습니다. 고를 때는 성능 순위보다 어디서 돌아가는지, 학생 데이터가 어디로 가는지, 승인 없이 무엇을 할 수 있는지를 먼저 보시면 됩니다.

2026년 5월부터 9월 사이 Google(Gemini Spark, 5월 19일 발표), xAI(Grok Bot, 8월 11일), Meta(Muse, 9월 8일), OpenAI(dots, 9월 29일)가 사용자 대신 컴퓨터와 브라우저를 다루는 상시형 에이전트를 잇따라 내놓았습니다. 이 글은 이 4종과 Hark Handoff, 오픈소스 3종을 같은 기준으로 비교합니다.

  • Meta Muse, OpenAI dots, Google Gemini Spark, xAI Grok Bot은 회사 클라우드의 컴퓨터에서 일하고, 사용자가 기기를 꺼도 작업을 이어 갑니다.
  • Hermes Agent, OpenClaw, Block Buzz는 내 PC나 직접 운영하는 서버에서 돌아갑니다.
  • dots와 Gemini Spark는 만 18세 이상만 쓸 수 있어 학생 계정에 나눠 줄 수 없습니다.
  • 자체 설치형은 데이터를 직접 쥘 수 있지만 보안 설정과 관리 책임도 직접 집니다.

비교 기준 다섯 가지

  • 어디서 돌아가나: 회사 클라우드인지, 내 컴퓨터나 자체 서버인지 봅니다.
  • 데이터는 어디 가나: 모델 학습에 쓰이는지, 연결을 끊은 뒤에도 기억이 남는지 봅니다.
  • 얼마나 스스로 움직이나: 발송·결제·삭제 전에 사람 승인을 받는지 봅니다.
  • 지금 쓸 수 있나: 한국 제공 여부, 연령 제한, 대기자 명단을 봅니다.
  • 비용: 무료인지, 기존 구독에 포함되는지 봅니다.

8개 에이전트 한 표로 보기

에이전트(회사) 어디서 돌아가나 데이터·권한 스스로 움직이는 정도 지금 쓸 수 있나(2026-10-11) 비용
Muse (Meta) 클라우드 전용 VM 학습 거부 가능, 광고와 공유 안 함 이메일 전송·구매 전 확인 미국·캐나다, 한국 공지 없음 대부분 무료, 구독 별도
dots (OpenAI) 클라우드 컴퓨터·브라우저 메모리 개별 삭제 불가 사전 탐색은 읽기 전용 Pro·Business Premium, 만 18세 이상 첫 dot 추가 비용 없음
Gemini Spark (Google) 클라우드 앱 연결 기본 꺼짐 지출·이메일 전송 전 확인 AI Pro·Ultra, 만 18세 이상 AI Pro·Ultra 구독
Grok Bot (xAI) Cursor 클라우드 컴퓨터 계정 안 Bot끼리 컴퓨터 공유 저장한 루틴을 일정대로 실행 포함 요금제, Enterprise 대기 요금제 포함, 사용량 별도
Handoff (Hark) 요청마다 전용 가상 컴퓨터 기존 계정으로 대신 로그인 승인 필요한 일은 먼저 확인 웹·iOS·Android, 한국 공지 없음 무료 + 유료 플랜
Hermes Agent (Nous Research) 내 컴퓨터 직접 관리 Bot Mode, 예약 작업 직접 설치 무료(MIT)
OpenClaw 노트북·홈랩·VPS 직접 관리 메신저로 지시 직접 설치 무료(MIT)
Buzz (Block) 자체 호스팅 릴레이 메시지마다 서명 기록 승인 게이트 일부 구현 직접 설치, 모바일 준비 중 무료(Apache 2.0)

표의 각 칸은 아래 제품별 절에 링크한 공식 자료(2026년 10월 11일 한국 시간 확인) 기준입니다.

빅테크 4종: 회사 클라우드에서 대신 일한다

Meta Muse

Meta는 2026년 9월 8일(미국 기준) 개인용 에이전트 Muse를 발표했고, 2026년 9월 29일(미국 기준) Muse for Small Business로 넓혔습니다. 장기 목표를 실행 계획으로 바꿔 이메일 전송, 여행 예약, 폼 작성 같은 일을 하고, Muse 앱이나 WhatsApp 메시지로 지시합니다. 에이전트와 데이터는 클라우드의 전용 가상 머신 ‘Muse Secure VM’에 있고, 같은 머신의 Sentinel 에이전트가 인터넷으로 나가는 행동을 승인합니다. 이메일 전송과 구매(Stripe Link 일회용 카드) 전에는 사용자 확인을 받습니다. 대화를 Meta AI 학습에서 빼는 설정이 있고, 사용자만 가진 키로 암호화하는 Muse Confidential VM은 올해 안에 나올 예정입니다. 2026년 9월 29일 기준 미국·캐나다에서 제공되며 한국 출시 공지는 없습니다(Meta Muse 정리 글).

OpenAI dots

OpenAI는 2026년 9월 29일(미국 기준) 항시 작동형 에이전트 dots를 발표했습니다. GPT-6 Astra로 돌아가고, 자체 클라우드 컴퓨터와 브라우저를 쓰며, 4,000개 이상 앱에 연결됩니다. 일을 맡기지 않을 때는 연결된 앱을 읽기 전용으로 살펴보는 ‘proactive research’를 하는데, 이때는 메시지 전송이나 앱 내용 변경을 하지 못합니다. dots 개인정보·보안 FAQ에 따르면 비밀번호 변경과 송금은 사용자가 직접 하고, 저장된 카드로 하는 구매는 승인이 필요합니다. 메모리는 하나씩 지울 수 없고, 플러그인 연결을 끊어도 이미 쌓인 정보는 남습니다. Business·Enterprise·Edu는 기본적으로 학습에 쓰지 않고, 개인 요금제는 설정에서 고릅니다. Pro와 Business Premium으로 나왔고, Enterprise는 관리자가 켜면 베타로 쓸 수 있으며, 만 18세 미만은 쓸 수 없습니다.

Google Gemini Spark

Google은 2026년 5월 19일(미국 기준) I/O에서 Gemini 3.5 기반 Gemini Spark를 발표했습니다. 폰과 노트북이 꺼져 있어도 클라우드에서 일을 계속합니다. Gmail, Calendar, Drive, Docs, Sheets 등과 연결할 수 있고 연결은 기본으로 꺼져 있으며, MCP로 다른 앱도 붙일 수 있습니다. 지출이나 이메일 전송 전에는 먼저 묻습니다. 2026년 7월 14일 AI Ultra 구독자에게 Gemini 앱 지원 지역(EEA·나이지리아·스위스·영국 제외)으로 열렸고, 7월 16일 미국 Pro, 7월 30일 Pro 160여 개국으로 넓어졌습니다(7월 업데이트). 만 18세 이상, Google AI Pro 또는 Ultra 구독이 필요합니다. 스프레드시트 업무에 붙이는 방법은 Gemini Spark와 구글 시트 자동화에 정리했습니다.

xAI Grok Bot

xAI는 2026년 8월 11일(미국 기준) Grok Bot을 베타로 내놓았고, 2026년 8월 26일 포함 요금제를 넓혔습니다. 24시간 일하는 에이전트 팀을 표방합니다. Cursor 문서에 따르면 한 계정의 Bot들은 Cursor 클라우드의 컴퓨터 하나를 함께 쓰며 파일·브라우저 세션·로그인을 공유하고, 사용자 사이는 엄격히 격리됩니다. 시연한 작업을 루틴으로 저장해 일정대로 돌리고, 승인이 필요하면 사용자에게 돌아옵니다. 공식 예시는 이메일·Drive·유료 구독 점검, 환불 처리, 영업 메일 초안이며, 삭제와 해지는 지시할 때만 합니다. SuperGrok·Plus·Heavy, Cursor Pro·Pro+·Ultra, Cursor Teams에 포함되고 Enterprise는 대기자 명단입니다. Bot 사용량은 기존 플랜과 따로 계산되며 주 단위로 초기화됩니다.

신생 1종과 오픈소스 3종

Hark Handoff

Handoff는 Brett Adcock의 AI 연구소 Hark의 컴퓨터 사용 에이전트로, 2026년 8월 5일(미국 기준) 연구 프리뷰로 나왔습니다. 요청마다 브라우저·파일 시스템·터미널을 갖춘 전용 가상 컴퓨터를 띄우고, 지속 메모리를 씁니다. Online-Mind2Web 인간 평가 리더보드(300개 과제, 136개 실제 웹사이트)에서 평균 97.67%로 1위(2위 Yutori Navigator 97.3%)에 올라 있습니다(2026년 10월 11일 확인). 다른 벤치마크 비교는 Hark 자체 측정입니다. 기존 계정을 연결해 대신 로그인하고, DoorDash·Target·OpenTable 작업을 시연했습니다. 승인이 필요한 일은 먼저 묻습니다. 웹·iOS·Android 앱으로 제공되고 무료 사용과 유료 플랜이 있으며, 한국 제공 공지는 없습니다.

Hermes Agent

Nous Research의 Hermes Agent는 MIT 라이선스 오픈소스로, 내 컴퓨터에 설치합니다(Windows 10·11 네이티브 지원). 2026년 8월 31일 v0.21.0에서 Bot Mode가 들어와 이름 붙은 에이전트들이 그룹 채팅에서 서로 대화하고, 예약 작업(cron)이 실행 사이 기억을 유지합니다. 칸반 기능과 하위 에이전트 위임(delegate_task)도 있습니다. 2026년 10월 8일 Microsoft Store에 올라와 Windows 11 22H2 이상에서 원클릭으로 설치됩니다. 같은 날 ASUS ProArt P16·P14에 탑재된다고 발표했고, 최대 128GB 통합 메모리에서 로컬 모델과 MuseTree·ComfyUI를 함께 씁니다.

OpenClaw

OpenClaw는 Clawd(Anthropic 요청으로 변경), Moltbot을 거쳐 2026년 1월 29일 지금 이름이 됐습니다. 노트북·홈랩·VPS에 설치하는 MIT 라이선스 오픈소스이고, WhatsApp·Telegram·Discord·Slack·Teams로 지시합니다. 2026년 1월 29일 발표 당시 GitHub 별 10만 개 이상, 한 주 방문자 200만 명이었습니다. 2026년 2월 14일 개발자 Peter Steinberger가 OpenAI 합류를 알리며 OpenClaw를 재단으로 옮겨 오픈소스로 유지한다고 밝혔습니다. 함께 이름이 나오는 Moltbook은 OpenClaw 기능이 아니라 에이전트들이 가입하는 별도 소셜 네트워크입니다.

Block Buzz

Block의 Buzz는 사람과 에이전트가 함께 쓰는 팀 워크스페이스로, Apache 2.0 오픈소스입니다. “Agents are members, not bots”라는 원칙대로 에이전트도 자기 키, 채널 멤버십, 감사 기록을 가집니다. 직접 운영할 수 있는 Nostr 릴레이 위에서 돌아가고, 모든 메시지가 서명된 이벤트로 남습니다. buzz-acp로 Goose·Codex·Claude Code를 채널에 연결합니다. 모바일 앱은 아직 준비 중이고, 워크플로 승인 게이트는 일부만 구현됐습니다.

‘스스로 움직인다’의 실제 범위

상용 서비스는 공통적으로 먼저 제안하고, 되돌리기 어려운 행동은 사람 승인을 받습니다.

  • dots: 알아서 하는 탐색은 읽기 전용입니다.
  • Muse: Sentinel이 밖으로 나가는 행동을 승인하고, 전송·구매는 사용자가 확인합니다.
  • Gemini Spark: 지출·이메일 전송 전에 묻습니다.
  • Grok Bot: 루틴은 일정대로 돌지만 승인이 필요하면 돌아옵니다.
  • 오픈소스 3종: 사용자가 준 키와 권한 안에서 움직이므로 승인 규칙도 직접 정해야 합니다.

학원 원장·교사가 고를 때 판단 기준

  1. 맡길 일을 ‘읽기’와 ‘보내기·결제’로 나눕니다. 공문 요약, 자료 검색은 읽기이고, 학부모 문자 발송, 수강료 청구는 보내기입니다.
  2. 학생·학부모 개인정보가 든 계정은 연결하지 않습니다. 성적표, 상담 기록, 원생 명부가 든 메일함과 시트는 뺍니다.
  3. 업무용 별도 계정과 한도가 낮은 카드로 시작합니다.
  4. 승인 규칙을 먼저 정합니다. 외부 발송, 영구 삭제, 결제는 모두 사람 승인을 거치게 합니다.
  5. 연령·지역·요금제를 확인합니다. dots와 Gemini Spark는 만 18세 이상입니다.
  6. 2주 시범 운영 후 활동 기록을 보고 범위를 넓힙니다.

예를 들어 공문·입시 요강 요약처럼 ‘읽기’만 하는 일은 상용 서비스로 2주 시범 운영하기 좋습니다. 학부모 문자 발송이나 수강료 청구처럼 ‘보내기·결제’가 들어가는 일은 승인 규칙을 켠 뒤에만 맡깁니다. 서버·포트 관리를 맡을 사람이 없다면 자체 설치형(Hermes Agent·OpenClaw·Buzz)은 시범 대상에서 빼는 편이 안전합니다.

도입 전 주의점

  • 개인 요금제는 학습 사용 설정을 확인하고, 원치 않으면 거부합니다.
  • dots는 연결을 끊어도 이미 쌓인 정보가 남습니다. 민감한 자료는 처음부터 넣지 않습니다.
  • 에이전트가 읽는 웹페이지나 메일에 숨은 지시가 섞일 수 있으니 권한은 최소로 줍니다.
  • 자체 설치형은 포트, 방화벽, 업데이트 관리를 학원이 맡습니다.

데이터가 어디로 가는지는 AI 도입, 우리 데이터는 어디로 가나, 업무 기기 관리는 Grok for Intune 점검 항목에서 이어서 보실 수 있습니다.

자주 묻는 질문

한국에서 지금 바로 쓸 수 있는 에이전트는 무엇인가요?

2026년 10월 11일 기준 Hermes Agent, OpenClaw, Buzz는 직접 내려받아 설치할 수 있습니다. Gemini Spark는 2026년 7월 14일 Google 공지가 AI Ultra 제공 범위를 ‘Gemini 앱 지원 지역 전체(EEA·나이지리아·스위스·영국 제외)’로 밝혀 한국의 AI Ultra 구독자도 대상에 들어갑니다. AI Pro 구독자는 2026년 7월 30일 160여 개국으로 넓어졌지만 Google이 국가 목록을 밝히지 않았습니다. Grok Bot은 포함 요금제 구독자에게 열려 있습니다. Muse는 미국·캐나다, dots는 OpenAI가 정한 대상 시장의 Pro·Business Premium 구독자에게 열려 있으며, Muse와 Hark는 한국 제공 공지가 없습니다.

오픈소스 에이전트가 더 안전한가요?

데이터 위치만 보면 내 컴퓨터나 서버에 두니 통제하기 쉽습니다. 대신 API 키 보관, 포트 관리, 권한 설정을 모두 직접 해야 합니다. 상용 서비스는 전용 VM과 승인 장치를 제공하지만 데이터가 회사 클라우드에 저장됩니다.

학생 계정으로 써도 되나요?

권하지 않습니다. dots와 Gemini Spark는 만 18세 이상만 쓸 수 있습니다. 원장과 교사의 행정·수업 준비용으로만 쓰는 편이 안전합니다.

출처 (2026년 10월 11일 한국 시간 기준 공식 자료)

제미나이 4 아르곤 열흘 점검: 강점·약점과 아직 못 쓰는 이유

제미나이 4 아르곤(Gemini 4 Argon)은 Google이 공개한 벤치마크 19개 중 13개에서 단독 1위, 1개에서 공동 1위입니다. 법률·금융 같은 지식 업무와 긴 문서 처리에서 강하고, 코딩은 시험에 따라 이기기도 지기도 합니다. 2026년 10월 11일 기준 일반 사용자와 일반 개발자는 아직 쓸 수 없고, 공개 날짜도 발표되지 않았습니다. 지금 쓰는 도구는 그대로 두고, 공개되면 우리 업무 과제로 할인 종료 후 가격을 따져 비교하면 됩니다.

기본 제원과 초기 발표 내용은 발표 직후 정리한 글에서 다루었습니다. 이번 글에서는 2026년 9월 30일(미국 기준) 발표 이후 열흘 동안 나온 외부 평가와 반응을 모아, 무엇이 확인됐고 무엇이 아직 정해지지 않았는지, 학원 원장과 교사가 지금 정할 일은 무엇인지 정리합니다.

한눈에 보기

  • 업무와 긴 문서 강세, 코딩은 혼선: 법률·금융 등 지식 업무와 긴 문맥 처리(최대 100만 토큰 구간을 재는 GraphWalks 포함)에서는 선두를 차지했으나, 진 5개 항목(코딩 2·과학 1·ML 1·컴퓨터 조작 1)에서는 경쟁 모델에 1위를 내주었습니다. 100만 토큰은 Google이 밝힌 출력 한도입니다.
  • 외부 리더보드 성적: Vals Index 1위(68.90%)와 Arena Text Arena 1위(1,525점)를 기록했으나, Code Arena WebDev 8위, Agent Arena 8위(약 3천 세션 잠정), Artificial Analysis 지수 53점 등 평가 환경에 따라 순위 편차가 큽니다.
  • 환각률 15.1%의 정확한 의미: Artificial Analysis 측정 기준 정답을 맞히지 못한 문항 중 틀린 답을 낸 비율이 15.1%로 낮았으나, 해당 지식 시험의 정답률은 49.9%에 머물렀습니다. 모를 때 틀린 답을 억지로 꾸며내지 않고 답을 아낄 뿐, 모든 질문에 답을 잘 맞히는 것은 아닙니다.
  • 일반 접근 불가: 현재는 사전 승인된 사이버 보안 방어 조직 대상 Fairwind 프로그램을 통해서만 열려 있으며, 개발자와 일반 소비자가 쓸 수 있는 공식 출시 일정은 공지되지 않았습니다.
  • 학원과 교사의 실무 대응: 지금 이용 중인 서비스를 유지하면서, 긴 문서 종합 업무와 코딩 자동화 업무를 분리하고 정상 가격(입력 $4, 출력 $20 per 1M 토큰) 기준으로 비용 대비 효용을 계산해 둘 시점입니다.

Google 발표 표: 이긴 항목과 진 항목

Google이 공개한 공식 벤치마크 표는 총 19개 항목으로 구성되어 있습니다(Google 발표 글, DeepMind 평가 방법론 문서). 제미나이 4 아르곤은 지식 업무, 긴 문맥, 멀티모달 등 13개 항목에서 단독 1위, 사이버 보안 1개 항목에서 공동 1위를 기록했습니다. 반면 코딩, 과학, 머신러닝, 컴퓨터 조작 분야 5개 항목에서는 경쟁 모델보다 점수가 낮았습니다.

분야 벤치마크 Gemini 4 Argon 1위 모델·점수 (Argon 1위 시 비교 모델 중 2위와 차이)
지식 업무 (Knowledge work) Vals Index 68.9% (단독 1위) 2위 Claude Opus 5.5 67.0% (+1.9%p)
지식 업무 (Knowledge work) AutomationBench (Score) 51.3% (단독 1위) 2위 Claude Opus 5.5 42.5% (+8.8%p)
지식 업무 (Knowledge work) Vals Finance Agent v2 65.4% (단독 1위) 2위 Claude Fable 5.1 58.9% (+6.5%p)
지식 업무 (Knowledge work) Harvey’s Legal Agent Benchmark 19.6% (단독 1위) 2위 Claude Fable 5.1 6.7% (+12.9%p)
에이전틱 코딩 (Agentic coding) DeepSWE v1.1 77.9% (단독 1위) 2위 Claude Opus 5.5 74.2% (+3.7%p)
에이전틱 코딩 (Agentic coding) FrontierSWE v2 55.0% 1위 GPT-6 Astra 65.5% (Argon 55.0%, -10.5%p)
에이전틱 코딩 (Agentic coding) Vibe Code Bench 91.9% (단독 1위) 공동 2위 Claude Fable 5.1 / Opus 5.5 90.3% (+1.6%p)
에이전틱 코딩 (Agentic coding) Terminal-bench 4.0 57.4% 1위 Claude Opus 5.5 66.4% (Argon 57.4%, -9.0%p)
머신러닝 엔지니어링 (ML engineering) PostTrainBench 45.3% 1위 Claude Opus 5.5 49.3% (Argon 45.3%, -4.0%p)
과학 및 수학 (Science and math) Terminal-Bench Science 0.1 57.6% 1위 GPT-6 Astra 68.1% (Argon 57.6%, -10.5%p)
과학 및 수학 (Science and math) LABBench 2 88.8% (단독 1위) 2위 GPT-6 Astra 85.4% (+3.4%p)
과학 및 수학 (Science and math) RiemannBench 76.0% (단독 1위) 2위 GPT-6 Astra 72.0% (+4.0%p)
긴 문맥 (Long context) GraphWalks up to 128k BFS (F1) 99.7% (단독 1위) 2위 GPT-6 Astra 98.7% (+1.0%p)
긴 문맥 (Long context) GraphWalks 256k to 1M BFS (F1) 84.2% (단독 1위) 2위 GPT-6 Astra 71.8% (+12.4%p)
컴퓨터 조작 (Computer use) Agent’s Last Exam (Pass rate) 39.5% (단독 1위) 2위 Claude Opus 5.5 38.2% (+1.3%p)
컴퓨터 조작 (Computer use) OSWorld-2.0 (Offline subset, partial score) 69.2% 1위 GPT-6 Astra 72.6% (Argon 69.2%, -3.4%p)
멀티모달 (Multimodal) Chartography 71.6% (단독 1위) 2위 GPT-6 Astra 71.0% (+0.6%p)
멀티모달 (Multimodal) LVBench 91.7% (단독 1위) 2위 GPT-6 Astra 87.5% (+4.2%p)
사이버 보안 (Cybersecurity) CWE-bench v1 68.0% (공동 1위) GPT-6 Astra 68.0% 공동 1위

표의 ‘2위’는 Google이 고른 비교 모델 3종 안에서의 순위입니다. Vals Index 리더보드 전체에서는 Claude Sonnet 5.5(67.04%)가 2위입니다. 비교 모델은 GPT-6 Astra, Claude Fable 5.1, Claude Opus 5.5이며, 비교 대상과 항목은 Google이 고른 것이라는 점을 감안해야 합니다. 지식 업무와 긴 문맥에서는 경쟁 모델을 앞섰지만, 복잡한 소프트웨어 공학 과제인 FrontierSWE v2와 터미널 환경 제어를 측정하는 Terminal-bench 4.0 등 5개 과제에서는 경쟁 모델에 1위를 내주었습니다.

외부 평가는 어떻게 나왔나

Google 자체 집계 표 외에 독립적인 평가 플랫폼과 외부 리더보드 결과는 영역별로 다른 양상을 나타냅니다.

  • Vals Index: Vals Index 리더보드에서 제미나이 4 아르곤은 68.90%의 종합 점수로 1위에 올랐습니다. 2026년 10월 7일 갱신 기준 2위는 Claude Sonnet 5.5(67.04%), 3위는 Claude Opus 5.5(66.97%)입니다. Vals AI 공식 계정에 따르면 평가를 진행한 22개 벤치마크 중 20개에서 상위 5위 안에 진입했으며, 특히 금융·법률·코딩·보안에서 강하다고 밝혔습니다.
  • Artificial Analysis: Artificial Analysis 페이지의 종합 지능 지수인 Intelligence Index v4.3.2에서 아르곤(High)은 53점(반올림 전 52.56)을 기록했습니다. 이는 Claude Opus 5.5(Max 57.62, 약 58점)와 Claude Sonnet 5.5(Max 56.00, 56점)보다 낮고 GPT-6 Astra(Max 52.67, 약 53점)와 대등한 수준입니다.
  • Arena: Arena 공식 계정 발표 기준 Text Arena에서 1,525점으로 1위를 차지했고(2위 Opus 4.6 High 대비 +20점), 코딩, 어려운 질문, 지시 수행, 긴 질의, 창작 글쓰기 부문 1위에 올랐습니다. 반면 실제 웹 환경 코딩 능력을 보는 Code Arena WebDev에서는 8위(1,679점)에 머물렀고, Agent Arena에서도 약 3,000건의 실제 세션을 반영한 잠정 평가에서 8위(+7.92% 순개선 점수)를 기록했습니다.
  • Blueprint-Bench 2: Andon Labs 공식 계정이 주관하는 평면도 작성 평가(아파트 실내 사진으로 평면도를 그리는 벤치마크)에서 1위를 차지했습니다.

2차 분석 매체인 The New Stack은 이를 종합하여 “코딩은 그럭저럭이지만 지식 업무는 A+”(Coding: so-so. Knowledge work: A+)라는 평가를 제시했습니다. 긴 문서를 정밀하게 읽고 종합하는 작업에는 강하지만, 도구를 활용해 복잡한 개발이나 에이전트 작업을 완결하는 능력에서는 평가 기준에 따라 큰 기복을 보입니다.

‘환각 15%’를 읽는 법

제미나이 4 아르곤 발표 직후 많은 주목을 받은 수치 중 하나는 Artificial Analysis 모델 페이지에 표시된 15.1%의 환각률(Hallucination Rate)이었습니다. 비교 대상인 Claude Fable 5.1(Max 72.6%), Claude Opus 5.5(추론 설정에 따라 High 67.6%~Max 58.6%), GPT-6 Astra(Max 51.3%), Claude Sonnet 5.5(Max 47.0%) 등 상위권 모델들의 환각률이 47~73%에 달했던 것과 대조하면 매우 낮은 수치로 비칩니다.

그러나 평가 정의 문서를 정확히 읽어야 합니다. 여기서 환각률은 ‘전체 답변 중 틀린 답변의 비율’이 아니라, 정답을 내지 못한 문항(오답 + 부분 정답 + 미시도) 중에서 틀린 답을 내놓은 비율(incorrect / (incorrect + partial + not attempted))을 뜻합니다.

실제 해당 AA-Omniscience 지식 시험에서 제미나이 4 아르곤의 정답률(Accuracy)은 49.9%였습니다. 이는 GPT-6 Astra Max(62.6%)나 Claude Opus 5.5 Max(66.2%)보다 낮습니다. 즉, 아르곤이 경쟁 모델보다 더 많은 지식을 알고 있어서가 아니라 “모를 때 틀린 답을 억지로 지어내는 대신 답변을 보류하거나 시도하지 않는 성향”이 강한 것입니다. “모를 때 지어내는 대신 답을 덜 한다”는 동작 특성과 “더 많이 안다”는 것은 전혀 다른 이야기입니다.

수업 준비와 평가를 담당하는 교사와 학원 실무자에게 이는 양면성을 가집니다. 이 시험에서는 모를 때 틀린 답을 내는 경우가 적었지만, 그만큼 답을 하지 않거나 부분적으로만 답한 경우가 많았습니다. 실제 수업 자료에서 어떻게 나타날지는 공개 뒤 직접 확인해야 합니다. 따라서 모델의 출력을 수업 자료로 그대로 제공할 수는 없으며, 교사의 최종 교차 검수 과정이 반드시 수반되어야 합니다. 한편 악의적인 입력에 대응하는 간접 프롬프트 주입(Gray Swan IPI 차트) 평가에서는 15회 시도 기준 공격 성공률이 0.7%로, 같은 차트의 Claude Opus 5.5(1.0%), GPT-6 Astra(8.5%)보다 낮았습니다. Google이 공개한 차트 기준입니다.

왜 아직 못 쓰나

2026년 9월 30일(미국 기준, 한국 시간 10월 1일 새벽) 발표된 모델임에도 열흘이 지난 지금까지 일반 사용자와 교육자가 이 모델을 접할 수 없는 이유는 Google의 단계적 배포 방침 때문입니다.

  • Fairwind 프로그램 전용 선행 배포: Google은 Fairwind 프로그램에 참여한 사이버 보안 방어 조직에만 먼저 모델을 열었고, 조직 안에서도 보안 담당 팀만 쓸 수 있습니다. 참여 조건과 가격은 발표 직후 정리한 글에 정리해 두었습니다.
  • 공개 순서: 유료 API 고객과 Google AI Ultra 구독자부터 출시한 뒤 개발자, 기업, 일반 소비자로 확대할 계획입니다.
  • 모델 카드 현황: 2026년 10월 11일 확인 시점에 DeepMind 공식 모델 카드 목록에 Argon 항목은 아직 등록되지 않았습니다.
  • 최근 확인된 정황: 2026년 10월 9일(미국 기준) Logan Kilpatrick은 X에서 @StatsWire의 지적에 “Argon is coming, fear not :)”라고 답했습니다. 날짜는 밝히지 않았습니다. 2026년 10월 9일(미국 기준) TestingCatalog는 Antigravity(숨김)에서 low, medium, high 추론 옵션을 지닌 Gemini 4 Argon 참조가 추가되었다고 전했으나 공식 공지는 아닙니다. 또한 Business Insider는 Google 직원들이 ‘Carbon’이라는 새 버전을 내부에서 시험 중이고, 한 직원이 “Opus 5.5 같은 느낌(feels like Opus 5.5)”이라고 말했다고 보도했습니다(Techmeme 요약). Google이 확인한 내용은 아닙니다.

반응: 기대와 의심

지난 열흘간 확인한 공개 반응은 크게 두 갈래였습니다.

  • 기대: Vals AI와 Arena 공식 계정이 발표 당일(2026년 9월 30일, 미국 기준) 각각 Vals Index 1위와 Text Arena 1위를 알렸고, 이 결과가 Google이 다시 선두권에 올랐다는 근거로 인용됐습니다.
  • 의심과 피로감: 사람들이 직접 써 볼 수 없는데 벤치마크 맞춤 점수(‘benchmaxxing’)만 내세운다는 비판(@diwakergupta 게시물)과, ‘Gemini 3.5 Pro 때도 곧 나온다고 했다’며 같은 일이 반복된다는 지적(@StatsWire 게시물)이 나왔습니다.

학원·교사가 지금 판단할 것

아직 쓸 수 없는 모델이므로, 지금 할 일은 도구를 바꾸는 것이 아니라 공개됐을 때 바로 비교할 준비를 해 두는 것입니다.

  1. 지금 쓰는 도구를 바꾸지 않는다: 아르곤은 현재 일반 사용자가 쓸 수 없는 상태이므로, 학원에서 지금 쓰는 ChatGPT, Claude, 기본 Gemini 등을 바꾸거나 해지할 이유가 없습니다.
  2. 원내 업무를 성격별로 나눠 적는다: 입시 요강 분석, 학원 학칙 검토, 긴 수험 자료 요약처럼 아르곤이 강점을 보이는 ‘긴 문서·자료 종합’ 업무와, 사이트 기능 수정이나 출결 자동화처럼 ‘코딩·프로그래밍’이 필요한 업무를 분리하여 목록화합니다.
  3. 비교 검증용 자체 과제 3~5개를 미리 만든다: 모델이 출시되었을 때 즉시 테스트할 수 있도록, 실제 학원에서 자주 마주치는 복잡한 과제(예: 복잡한 3개년 입시 요강 비교표 작성, 장문 수능 국어 지문 요약 및 핵심 출제 포인트 추출 등)와 정답 기준을 준비합니다.
  4. 정상 가격 기준으로 비용을 계산한다: 도입 초기 할인가(입력 $2, 출력 $10 per 1M 토큰) 이후 적용될 정가인 입력 $4, 출력 $20 per 1M 토큰(발표 글 각주 1) 기준으로 예산을 잡습니다. 할인 기간은 밝혀지지 않았습니다(가격 상세는 발표 직후 정리한 글 참고).
  5. ‘모르겠다’는 답변 처리 기준을 수립한다: 지식 시험 정답률 특성을 감안하여, 모델이 “답을 알 수 없다”며 작업을 멈추거나 보류할 때 이를 보완할 교사의 검수 단계와 추가 확인 절차를 미리 정해둡니다.
  6. 학생과 학부모의 개인정보 입력 금지 원칙을 지킨다: 어떤 모델이든 원생 성적표, 학부모 상담 내역, 이름, 전화번호 등 식별 가능한 민감 개인정보는 외부 클라우드 AI 시스템에 일체 입력하지 않는 원칙을 지킵니다.

판단 기준 체크리스트:

  • 긴 규정집·입시 자료처럼 여러 문서를 함께 읽고 종합하는 업무 비중이 높은가?
  • 틀린 답을 그럴듯하게 꾸며내는 위험을 피하는 것이, 답변 보류로 인해 누락되는 것보다 더 중요한가?
  • 백만 토큰당 정상 가격(입력 $4, 출력 $20)을 지불하더라도 교직원의 작업 시간 절감 가치가 더 큰가?
  • 코딩 자동화가 주목적일 때 터미널 제어 및 프런티어 코딩 지표의 열세를 확인했는가?

자주 묻는 질문

Q1. 제미나이 4 아르곤을 지금 바로 유료 구독해서 쓸 수 있나요?

아닙니다. 2026년 10월 11일 기준 일반 개발자와 일반 사용자는 이용할 수 없습니다. 현재는 사전 승인된 사이버 보안 방어 조직 대상의 Fairwind 프로그램을 통해서만 접근이 가능합니다. 향후 유료 API 고객과 Google AI Ultra 구독자를 시작으로 순차 제공될 예정이지만 구체적인 정식 공개 날짜는 미정입니다.

Q2. 코딩과 프로그래밍 업무에서도 가장 뛰어난 모델인가요?

그렇지 않습니다. DeepSWE v1.1(77.9%)이나 Vibe Code Bench(91.9%)에서는 1위를 기록했지만, 복잡한 프런티어 과제를 다루는 FrontierSWE v2(55.0% vs GPT-6 Astra 65.5%)와 터미널 환경을 제어하는 Terminal-bench 4.0(57.4% vs Claude Opus 5.5 66.4%)에서는 1위를 내주었습니다. 외부 리더보드인 Code Arena WebDev에서도 8위에 머물러 작업 성격에 따라 성능 편차가 큽니다.

Q3. 환각 15%면 생성된 문제나 해설을 그대로 믿고 써도 되나요?

그대로 믿고 사용해서는 안 됩니다. 15.1%라는 환각률은 ‘정답을 내지 못한 문항 중 틀린 답을 지어낸 비율’을 의미하며, 해당 지식 시험의 정답률은 49.9%에 그쳤습니다. 틀린 답은 적을지언정 문제 해결을 보류하거나 답을 내지 못할 확률이 존재하므로, 생성된 교육 콘텐츠와 채점 결과는 반드시 교사의 세밀한 교차 검증을 거쳐야 합니다.

확인 시각 및 출처

2026년 10월 11일 오전(한국 시간) 확인

1차 출처:

2차 출처:

발표 당시의 기본 제원과 초기 비교는 발표 직후 정리한 글을 참고하시기 바랍니다.

AI 비용은 토큰보다 다시 하는 데 샌다

한눈에 보기

  • 비용은 토큰이 아니라 완료된 업무 기준으로 본다
  • 턴 수·캐시·출력·모델이 비용을 만든다
  • 실패한 재시도가 가장 비쌀 수 있다

AI 비용은 토큰 단가가 아니라 하나의 업무를 끝내는 데 든 비용으로 계산해야 합니다. 턴 수, 캐시, 출력량, 모델과 effort를 함께 봐야 하며, 가장 싼 시도를 고르다가 실패해 다시 하는 일이 오히려 비쌀 수 있습니다.

왜 토큰보다 완료 비용을 봐야 하나요?

대화형 작업에서는 매 턴 앞선 대화 전체를 다시 보내므로, 필요한 턴의 수가 늘수록 입력 비용도 쌓입니다. 가장 싼 턴은 애초에 필요하지 않았던 턴일 수 있습니다. 토큰을 줄이는 방법이 작업을 끝내지 못하게 해 재시도를 부르면, 아낀 비용보다 재시도 비용이 커질 수 있다는 점은 별도로 봐야 합니다.

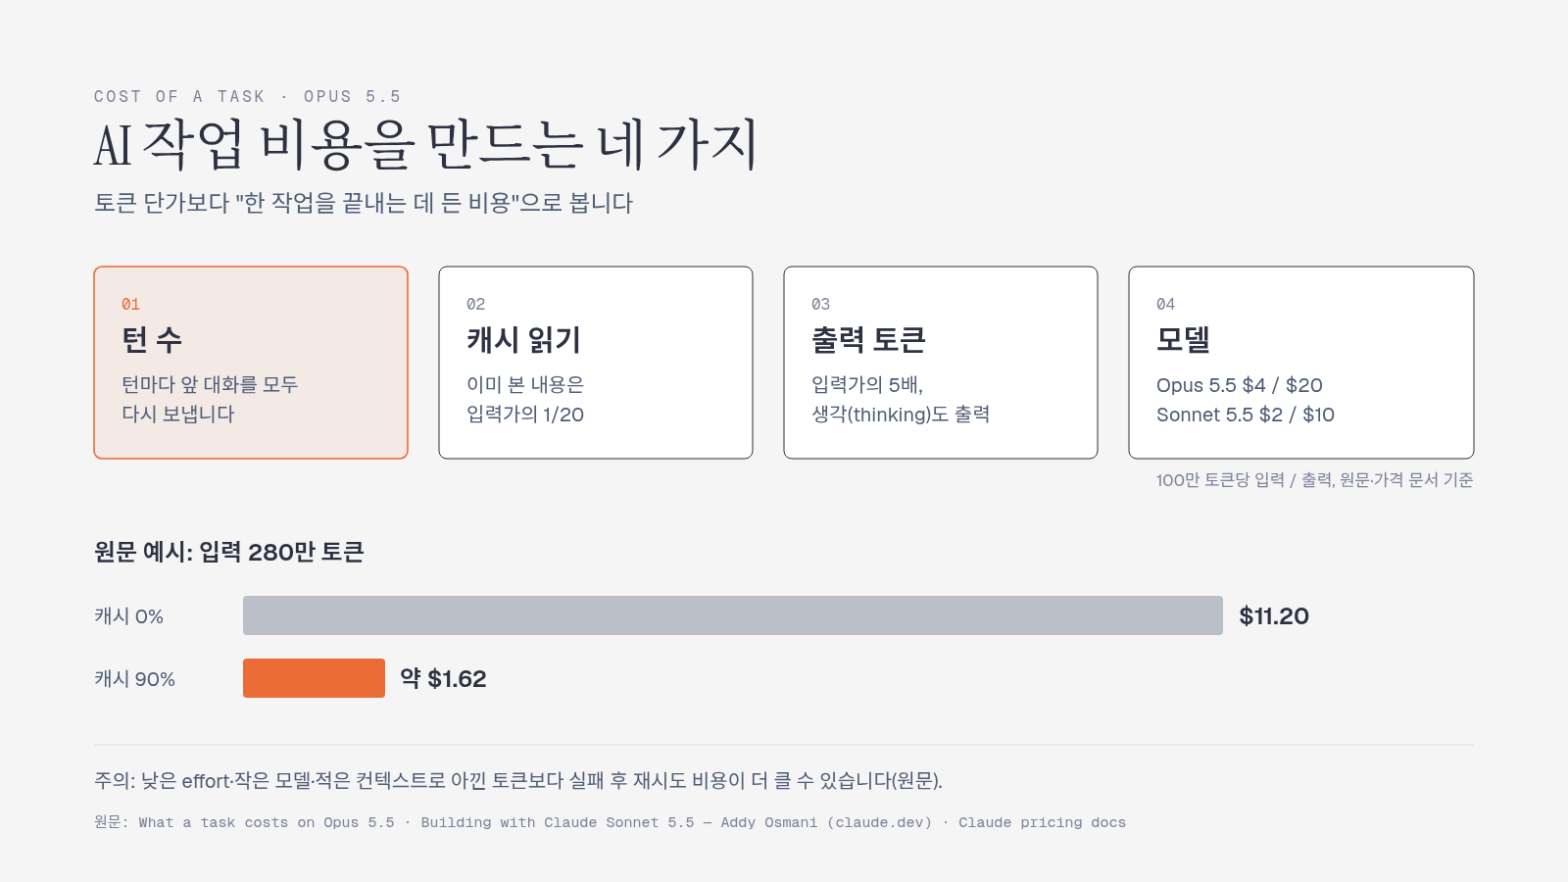
원문이 나누는 비용 요인은 턴 수(turn), 캐시 읽기, 출력 토큰, 모델입니다. Opus 5.5에서 캐시 읽기는 입력가의 20분의 1 수준입니다. 원문 예시에서 40턴 동안 대화가 2만→12만 토큰으로 커지면 작업 전체 입력은 약 280만 토큰이고, 캐시가 전혀 없으면 11.20달러, 90%가 캐시에서 읽히면 약 1.62달러입니다. 반복되는 지침과 자료를 캐시할 수 있는 구조인지 먼저 살펴볼 이유입니다.

출력 토큰은 입력보다 비싸고, 생각하는 과정도 출력으로 계산됩니다. Opus 5.5의 1M 토큰 기준 가격은 입력 4달러, 출력 20달러, 캐시 읽기 0.20달러이며 출력은 입력의 5배입니다. Opus 5 대비 입력과 출력은 20% 낮고 캐시 읽기는 60% 낮다는 비교도 함께 제시됩니다. 따라서 긴 설명을 매번 생성하거나 불필요한 재검토를 반복하지 않는 것이 중요합니다.

어떤 모델을 고르면 좋을까요?

Sonnet 5.5는 Claude 5.5 가족에서 Opus 5.5 다음 모델이며 Sonnet 5보다 30% 빠릅니다. Sonnet 5와 토큰 단가는 같지만 같은 일을 더 적은 토큰으로 처리하는 경우가 많아 대부분의 작업에서 최대 30% 저렴할 수 있고, 1M 토큰 기준 입력 2달러·출력 10달러입니다. 범위가 분명한 일상 업무와 빠른 반복에는 Sonnet 5.5를 먼저 보고, 가장 어려운 장기 작업과 신중한 판단에는 Opus 5.5를 선택하는 구분이 합리적입니다.

참고로, Claude Code 공식 비용 문서에 따르면 기업 배포에서 Claude Code를 쓰는 개발자가 실제로 쓴 날(활동일) 기준 1인당 평균 약 13달러이고, 90%는 30달러 미만입니다. 이 수치는 Claude Code의 활동일 비용이지 일반 채팅 앱 청구액이 아닙니다.

학원 업무에는 어떻게 적용할까요?

비용표를 아는 것만으로는 부족합니다. 어디에서 다시 시키는 일이 생기는지(입력 자료 누락, 모호한 완료 기준, 검사 단계 없음) 찾아야 합니다. 상담 자료를 매번 다시 넣기보다 고정 지침과 자주 쓰는 정책이 캐시 대상인지 살핍니다. 형식 정리는 Sonnet 5.5의 낮은 effort로 시작하고, 학부모 안내와 장기적인 커리큘럼 설계는 더 강한 모델과 검증 단계로 보냅니다. 비용표에는 모델별 단가뿐 아니라 성공까지의 턴 수와 사람의 재검토 시간도 적습니다.

완료 비용을 낮추기 전에 정해 둘 다섯 가지

  • 업무별로 첫 시도, 재시도, 사람 검토까지 포함한 완료 비용을 기록합니다.
  • 반복해서 보내는 정책·양식·참고자료가 캐시 대상인지 확인합니다.
  • 초안·형식 정리는 Sonnet 5.5부터, 어려운 장기 판단은 Opus 5.5부터 비교합니다.
  • 출력이 길어지는 이유와 생각·검증 단계가 필요한 이유를 구분합니다.
  • 모델을 바꿀 때 품질, 성공까지의 시도 수, 총 비용을 같은 사례로 비교합니다.

자주 묻는 질문

캐시를 쓰면 항상 비용이 크게 줄어드나요?

반복 입력이 충분하고 실제로 캐시 읽기로 처리될 때 효과가 있습니다. 짧거나 매번 내용이 바뀌는 요청에는 절감 폭이 달라질 수 있으므로, 사용량 기록으로 확인해야 합니다.

작은 모델이 항상 더 싼가요?

토큰 단가만 보면 그럴 수 있지만, 실패해 다시 시키거나 사람이 많이 고치면 완료 비용은 커집니다. 범위가 분명한 작업은 Sonnet 5.5로 시작하고, 어려운 작업은 한 번에 맞히는 품질까지 함께 비교하세요.

하루 13달러면 학원 채팅 비용도 그 정도인가요?

아닙니다. 그 수치는 Claude Code를 실제로 사용한 기업 개발자의 활동일 비용에 대한 공식 문서 수치입니다. 학원용 채팅이나 API의 비용은 모델, 입력·출력량, 캐시, 사용 횟수로 따로 계산해야 합니다.

출력 토큰을 줄이면 무조건 이득인가요?

출력을 줄여도 결과가 불완전해져 재작업이 생기면 절약이 사라질 수 있습니다. 먼저 완료 조건을 만족하는 최소한의 결과를 정하고, 불필요한 장황함만 줄이세요.

출처

이 글은 claude.dev 원문을 학원 운영 관점에서 요약·해설한 글이며 번역이 아닙니다.

AI에게 일의 힘을 조절해 쓰는 법

한눈에 보기

  • effort는 AI가 쓸 생각의 양을 조절하는 설정
  • 설정 단계와 실전 사용표는 구분하기
  • 초안은 가볍게, 검수는 필요할 때 깊게

AI의 effort는 한 작업에 얼마나 많은 생각과 검증을 들일지 조절하는 설정입니다. 모든 업무를 가장 높은 단계로 처리하기보다 초안·일상 업무·중요한 검증을 나누면 속도와 품질을 함께 관리할 수 있습니다.

설정 단계와 사용표를 왜 구분하나요?

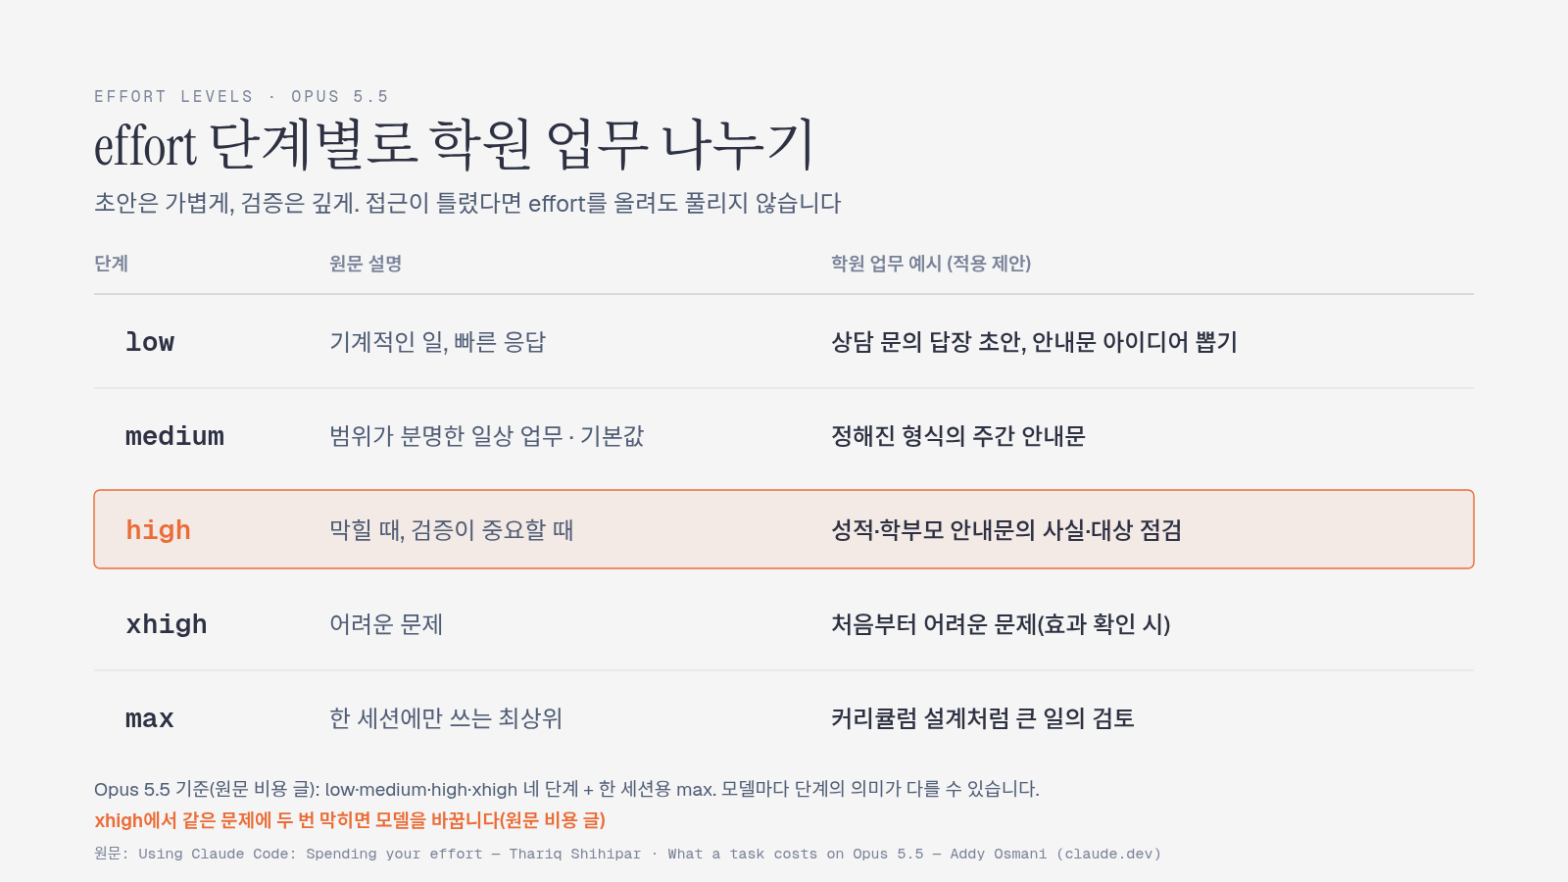
비용 글 “What a task costs on Opus 5.5” 기준으로 Opus 5.5의 effort는 low, medium, high, xhigh 네 단계이고, 한 세션에서만 쓰는 max가 따로 있습니다. Opus 5.5의 기본값은 medium입니다. 모델마다 단계의 의미가 다를 수 있습니다. 글쓴이 Thariq의 사용 기준표는 low, medium, high, max 네 가지입니다. 설정 단계와 업무 기준표를 같은 것으로 읽지 않는 것이 좋습니다.

원문이 제안한 루틴은 다음과 같습니다. “AI가 나를 인터뷰해 스펙을 만들게 하고 → low로 구현 → 리뷰(필요하면 low로 반복) → high로 검증·테스트”. 먼저 무엇을 만들지 정리하고, 구현은 빠르게 진행한 뒤, 사람이 결과를 읽고 마지막 검증에 더 많은 생각을 배정하는 흐름입니다.

높은 effort는 빠져나갈 구멍이나 숨은 예외를 찾는 데 도움이 됩니다. 다만 접근 자체가 틀렸다면 생각을 더 오래 시켜도 올바른 방향으로 바뀌지 않습니다. 원문의 64%에서 87%로 오른 결과는 일반 업무 평균이 아니라 Fable 5.1의 Terminal-Bench 3.0 보안 범주에서 낮은 effort에서 최상위 effort로 올렸을 때의 내부 실행 결과입니다(원문 그림은 낮은 쪽은 가장 낮은 두 설정, 높은 쪽은 가장 높은 세 설정을 묶은 값으로 보여줍니다).

학원 업무에는 어떤 단계를 배정할까요?

상담 문의 초안은 low로 시작할 수 있습니다. 정해진 형식의 일상 안내문은 medium, 성적이나 학부모 안내처럼 사실과 표현을 함께 점검해야 하는 문서는 high로 검증합니다. 커리큘럼 설계처럼 여러 조건을 비교하고 오래 검토해야 하는 일은 max로 검토하되, 먼저 목표와 제약을 분명히 적어야 합니다. medium에서 막히면 high로 올리고, 처음부터 어려운 문제에는 xhigh를 검토할 수 있습니다. 다만 비용 글은 xhigh와 max를 효과를 확인한 일에 남겨 두라고 하고, xhigh에서도 같은 문제에 두 번 막히면 단계를 더 올리기보다 모델을 바꾸라고 권합니다.

이렇게 나누면 “항상 깊게”라는 막연한 지시 대신 업무 단계별 예산이 생깁니다. 낮은 단계에서 만든 초안도 검토 대상이고, 높은 단계는 잘못된 목표를 고치는 만능 버튼이 아니라 검증을 강화하는 도구라는 점을 기억해야 합니다.

학원 업무의 effort를 정하는 순서

  • 업무를 초안·일상 처리·중요 검증·어려운 설계로 나누고 기본 effort를 정합니다.
  • 상담 문의 초안은 low, 일상 안내문은 medium에서 먼저 시작합니다.
  • 성적·학부모 안내는 high에서 사실·대상·예외를 다시 확인하게 합니다.
  • 커리큘럼 설계는 max 검토 전에 목표, 제약, 완료 조건을 문장으로 적습니다.
  • 낮은 단계의 결과를 사람이 리뷰하고, 필요한 경우 같은 단계로 반복합니다.
  • 단계별 결과의 품질과 소요 시간을 기록해 다음 배정 기준을 조정합니다.

자주 묻는 질문

모든 일을 max로 처리하면 가장 좋지 않나요?

그렇지 않습니다. 더 오래 생각해도 입력된 목표나 접근이 틀렸다면 결과가 좋아지지 않으며, 속도와 비용은 커질 수 있습니다.

effort를 올리면 잘못된 접근도 고쳐지나요?

effort는 검토와 생각의 양을 늘리는 설정이지 문제 정의를 자동으로 다시 쓰는 장치가 아닙니다. 결과가 계속 빗나가면 먼저 요구사항과 완료 조건을 다시 정리해야 합니다.

작업 중간에 effort를 바꿀 수 있나요?

Claude Code에서는 대화 중에도 /effort high처럼 effort를 바꿀 수 있습니다. 비용 글 기준으로 API 키나 구독으로 쓰면 바꿔도 프롬프트 캐시가 유지됩니다. 클라우드 제공업체나 게이트웨이를 거친다면 작업이 끊기는 시점에 바꾸는 편이 낫습니다.

리뷰 후에도 같은 effort를 쓰는 이유는 무엇인가요?

리뷰에서 고칠 지점이 구현의 세부 문제라면 낮은 단계로 반복해도 충분할 수 있습니다. 마지막에 전체 요구사항과 예외를 확인할 때 높은 단계로 올리는 것이 원문이 제안한 흐름입니다.

출처

이 글은 claude.dev 원문을 학원 운영 관점에서 요약·해설한 글이며 번역이 아닙니다.

AI 지시문은 길이보다 충돌이 문제다

한눈에 보기

  • 긴 지시문보다 충돌 없는 판단 기준이 중요하다
  • 필요한 자료는 필요할 때 꺼내게 한다
  • 컨텍스트를 업무 환경처럼 설계한다

AI의 답변이 흔들릴 때 지시문부터 길게 만들 필요는 없습니다. 서로 충돌하는 규칙을 먼저 줄이고, 핵심 판단 기준과 필요한 참고자료를 작업의 적절한 시점에 제공하는 컨텍스트 설계가 더 중요할 수 있습니다.

지시문을 줄여도 괜찮다는 근거는 무엇인가요?

원문이 말하는 근거의 범위는 분명합니다. Claude Opus 5와 Claude Fable 5 같은 Claude 5 세대 모델에서, Claude Code 시스템 프롬프트를 대상으로, Anthropic 자체 코딩 평가를 했을 때 80% 이상을 줄여도 측정 가능한 손실이 없었다는 결과입니다. 모든 모델과 업무에서 규칙을 지워도 된다는 뜻은 아닙니다.

원문은 그동안 시스템 프롬프트·CLAUDE.md·스킬로 Claude를 과하게 제약해 왔다는 점을, 지시문을 많이 덜어 내도 괜찮았던 배경으로 설명합니다. 이유 중 하나는 한 요청 안에서 지시가 서로 부딪혔기 때문입니다. “상황에 맞게 문서화하라”와 “주석을 추가하지 마라”가 동시에 있으면 AI는 대체로 사용자의 의도를 파악하지만, 무엇을 할지 정하기 전에 겹치고 부딪히는 지시를 더 신중하게 따져야 합니다. 따라서 문장을 더 보태기 전에 금지·예외·우선순위가 같은 상황에서 충돌하는지부터 읽어야 합니다.

학원 문서는 어떻게 설계할까요?

상담봇에는 규칙을 많이 나열하기보다 반드시 지킬 핵심을 남깁니다. 예를 들어 모르는 정보는 단정하지 않기, 개인정보가 필요한 상황은 사람에게 넘기기, 짧게 답하기처럼 행동 기준을 분명히 씁니다. 그다음 복잡한 예외와 참고자료는 질문이 생겼을 때 꺼내 보도록 나눕니다. 모든 내용을 처음에 넣지 않고 필요한 순간에 꺼내 쓰게 하는 방식을 원문은 progressive disclosure(점진적 공개)라고 부릅니다.

워크북 정책 문서는 “무엇을 하지 말라”는 문장만 늘리기보다 도구와 결과의 인터페이스를 명확히 해야 합니다. 입력 파일의 형식, 검사 명령, 합격 기준, 예시 결과를 연결하면 AI가 판단할 재료가 생깁니다. 설명을 반복해서 붙이는 대신 짧은 도구 설명과 풍부한 참고자료를 배치하는 조합입니다.

원문이 제안하는 다른 방향도 이 두 사례에 연결됩니다. 매번 모든 규칙을 복사하기보다 필요한 기억은 자동으로 남기고, 단순한 마크다운 메모 대신 HTML 결과물, 테스트, 기준표 같은 더 풍부한 참고자료를 줄 수 있습니다. 지시를 줄이는 일은 정보를 버리는 일이 아니라, 규칙과 자료의 역할을 분리하는 일입니다.

컨텍스트를 덜어내기 전에 확인할 것

  • 상담봇 지시문에서 서로 반대되는 금지·허용 문장을 찾아 하나의 우선순위로 정리합니다.
  • 개인정보·환불·성적처럼 반드시 사람 판단이 필요한 조건을 핵심 규칙으로 남깁니다.
  • 상세 예외와 정책 문서는 처음부터 모두 넣지 말고 필요한 질문에서 꺼내게 합니다.
  • 워크북 정책에 입력 형식, 검사 방법, 합격 기준, 예시 결과를 연결합니다.
  • 반복되는 도구 설명은 짧게 쓰고, 테스트·기준표·참고자료는 별도 자료로 관리합니다.
  • 규칙을 줄인 뒤에는 대표 상담과 검수 사례로 품질 변화를 다시 평가합니다.

자주 묻는 질문

지시문은 짧을수록 좋은가요?

짧다는 이유만으로 좋은 것은 아닙니다. 충돌 없이 우선순위가 분명하고, 필요한 자료를 AI가 찾을 수 있는지가 더 중요합니다.

모든 규칙을 한 번에 주지 않으면 잊지 않나요?

항상 필요한 핵심 규칙은 앞에 두고, 드물게 쓰는 예외와 자료는 필요한 시점에 읽게 할 수 있습니다. 이 방식은 긴 문서를 줄이는 동시에 상황에 맞는 근거를 남깁니다.

상담봇 규칙을 줄이면 안전성이 떨어지지 않나요?

안전과 관련된 조건을 삭제하라는 뜻이 아닙니다. 개인정보나 사람에게 넘길 조건처럼 반드시 지켜야 할 기준은 간결하고 우선순위가 분명하게 남기고, 중복되거나 충돌하는 표현을 정리하는 것입니다.

규칙을 정리한 뒤 무엇을 확인해야 하나요?

대표적인 정상 사례와 예외 사례를 같은 기준으로 시험하세요. 답변의 정확성뿐 아니라 필요한 자료를 찾는지, 사람에게 넘겨야 할 상황을 놓치지 않는지도 함께 봐야 합니다.

출처

이 글은 claude.dev 원문을 학원 운영 관점에서 요약·해설한 글이며 번역이 아닙니다.

AI 직원에게도 매뉴얼보다 하네스가 필요하다

한눈에 보기

  • 하네스는 AI가 일하는 작업 틀
  • 만드는 에이전트와 검사하는 에이전트를 분리
  • 긴 업무에는 분해·검증·반복을 넣기

AI에게 긴 업무를 맡길 때는 한 번의 지시보다 작업을 나누고, 결과를 따로 검사하고, 기준에 닿을 때까지 반복하는 하네스가 효과적입니다. 하네스는 AI를 감싸는 업무 흐름이며, 무엇을 만들지뿐 아니라 어떻게 실패를 발견할지도 정해 둡니다.

하네스는 프롬프트와 어떻게 다르나요?

프롬프트가 한 번의 요청과 기준을 전달한다면, 하네스는 그 요청을 실행하는 순서와 역할을 구성합니다. Claude 공식 개발자 블로그는 작업의 성격을 보고 Claude가 자기 하네스를 만드는 동적 워크플로를 설명합니다. 단순한 답변에는 필요 없지만, 여러 자료를 비교하거나 결과물을 여러 번 고쳐야 하는 일에는 작업 틀이 중요해집니다.

하네스가 필요한 이유는 세 가지 실패가 반복되기 때문입니다. AI가 실제 작업을 다 하지 않고 끝났다고 말하는 agentic laziness, 자기 결과물을 다른 안보다 좋게 보는 self-preferential bias, 긴 작업에서 처음 목표를 잃는 goal drift입니다. 이 문제는 과정 안에 검사 지점을 넣어야 찾기 쉽습니다.

어떤 패턴을 골라야 하나요?

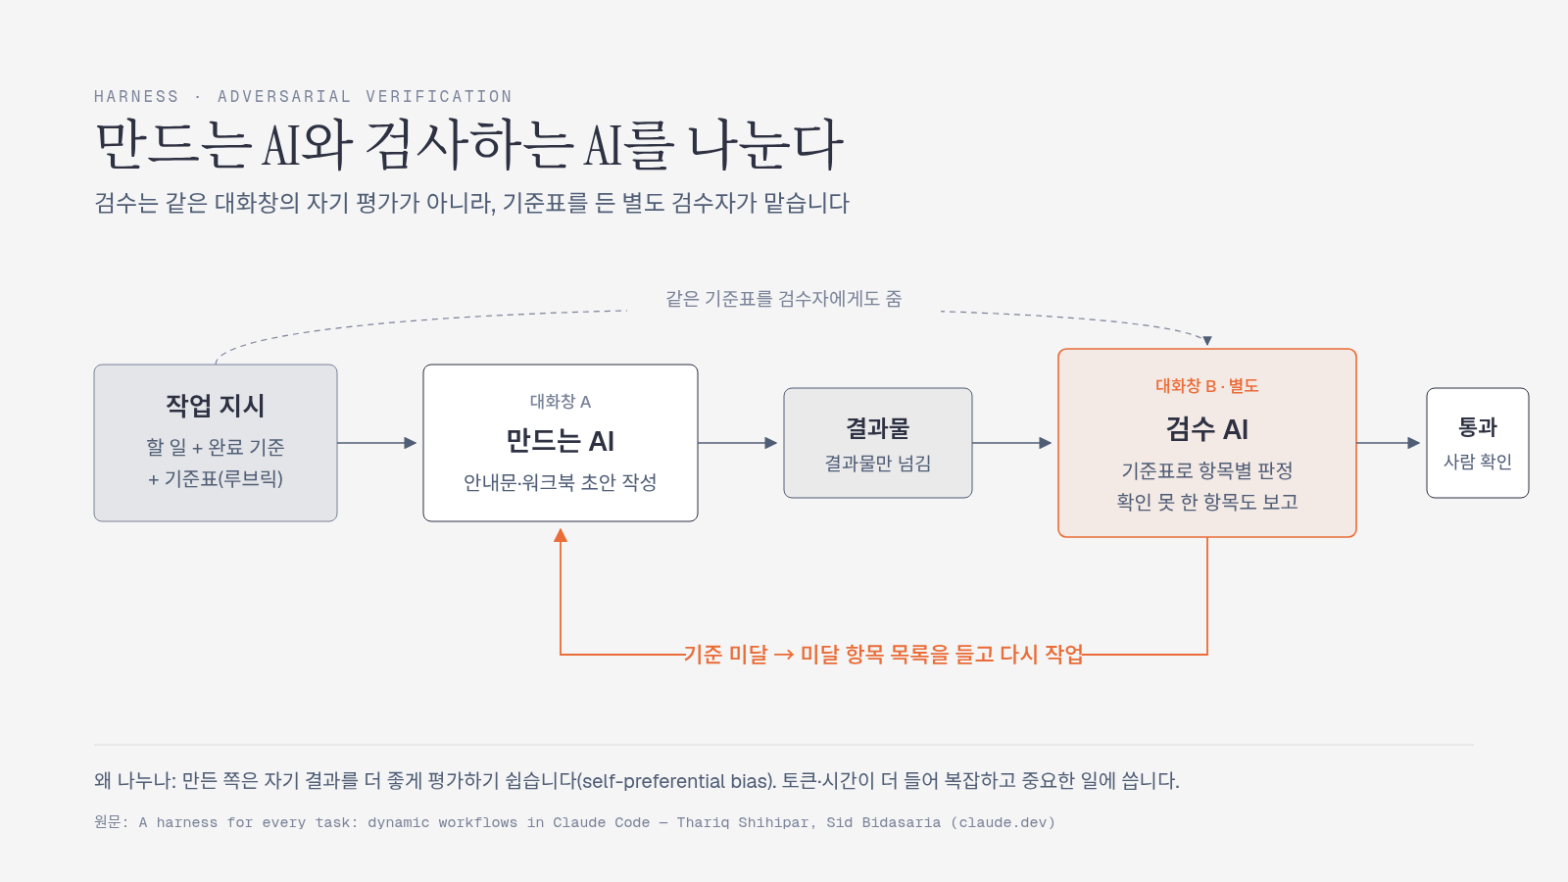
원문에서 소개하는 패턴은 여섯 가지입니다. classify-and-act는 먼저 요청의 종류를 분류해 맞는 행동으로 보내고, fan-out-and-synthesize는 여러 에이전트에게 나눠 맡긴 뒤 결과를 합칩니다. adversarial verification은 만든 에이전트가 아니라 별도의 에이전트가 기준표와 결과물만 받아 검증하는 방식입니다.

generate-and-filter는 여러 결과를 만든 뒤 조건에 맞지 않는 것을 걸러냅니다. tournament는 후보를 서로 겨루게 해 더 나은 안을 고르고, loop until done은 일의 양을 모를 때 새 발견이나 오류가 더 없다는 멈춤 조건을 만족할 때까지 에이전트를 반복 실행합니다. 예를 들어 상담 문의를 분류하고, 답변 후보를 만든 뒤, 별도 검수 단계가 개인정보·정책·문체를 확인하게 할 수 있습니다.

학원 업무에는 어떻게 적용할까요?

워크북 제작은 자료 조사, 초안 작성, 문항 연결 검사, 최종 형식 점검으로 나눌 수 있습니다. 만든 에이전트가 “완료”라고 말하는 것과 별개로 검사 역할을 두어 누락·오탈자·페이지 넘침을 확인하게 하세요. 주간 리포트도 학생별 자료를 나눠 처리한 뒤 하나의 형식으로 합치고, 합치기 전에 누락 여부를 다시 검사할 수 있습니다.

하네스는 작업이 복잡할수록 유리하지만, 모든 요청에 붙이면 토큰과 시간이 늘어납니다. Claude Code에서는 Claude에게 워크플로를 만들어 달라고 하거나 트리거 단어 ‘ultracode’를 쓰면 워크플로를 만듭니다(원문).

오늘의 액션

긴 업무를 맡긴 대화창이 스스로 검수하지 않게 하세요. 결과물과 기준표만 다른 대화창(또는 다른 AI)에 넘겨 검수를 따로 맡기고, 미달 항목만 원래 작업 쪽에 돌려보냅니다.

긴 업무에 하네스를 붙일 때 확인할 것

  • 업무를 분류·실행·검수·반복 단계로 나누고 각 단계의 완료 조건을 적습니다.
  • 여러 자료나 후보가 필요하면 fan-out-and-synthesize로 나눠 처리한 뒤 합칩니다.
  • 결과를 만든 에이전트와 기준표로 검수하는 에이전트를 별도로 둡니다.
  • 초안은 여러 개 만들고(generate-and-filter), 중요한 선택은 후보끼리 비교합니다.
  • 검수에서 떨어진 결과는 검수 의견을 붙여 다시 만들게 하고, 사람이 넘겨받을 시점을 미리 적어 둡니다.
  • 토큰과 시간이 많이 드는 업무인지 확인한 뒤 하네스를 적용합니다.

자주 묻는 질문

하네스는 긴 프롬프트와 같은 것인가요?

아닙니다. 프롬프트는 기준을 설명하는 문장이고, 하네스는 여러 실행·검수·반복을 연결하는 작업 흐름입니다. 한 번의 답변으로 끝나는 업무에는 프롬프트만으로 충분할 수 있습니다.

만든 AI에게 다시 자기 결과를 검수하게 해도 되나요?

자기 결과를 선호하는 편향이 생길 수 있으므로 중요한 업무에서는 피하는 편이 좋습니다. 다른 대화창 또는 다른 AI에 기준표와 결과물만 주고 검수를 따로 맡기면 역할이 분리됩니다.

모든 학원 업무에 하네스를 써야 하나요?

아닙니다. 간단한 안내나 짧은 초안은 오히려 조정 비용이 더 클 수 있습니다. 오류의 영향이 크고 반복되는 업무부터 작은 흐름으로 시험하세요.

반복은 언제 멈추게 해야 하나요?

합격 기준을 만족하거나 정한 횟수에 도달하면 멈추고, 남은 문제를 사람에게 보고하게 하세요. 종료 조건이 없으면 개선 루프가 비용과 시간을 계속 사용할 수 있습니다.

출처

이 글은 claude.dev 원문을 학원 운영 관점에서 요약·해설한 글이며 번역이 아닙니다.

AI도 실전에 넣기 전 시험해야 한다

한눈에 보기

  • 실전과 닮은 시험을 먼저 만든다
  • 만드는 모델과 채점하는 모델을 분리한다
  • 탐색용 점수와 실전 점수를 나눠 본다

AI를 실제 업무에 연결하기 전에는 실전과 닮은 사례와 합격 기준으로 먼저 시험해야 합니다. eval은 AI의 업무 수행을 재는 평가이고, 만드는 AI와 채점하는 AI를 분리하면 느낌이 아니라 반복 가능한 기록으로 품질을 비교할 수 있습니다.

좋은 eval은 무엇을 갖춰야 하나요?

원문은 좋은 평가에 네 가지 조건이 필요하다고 설명합니다. 실제 업무를 닮아야 하고, 더 강한 모델이나 더 많은 생각을 쓸수록 점수가 올라갈 여지가 있어야 합니다. 최상위 모델도 만점을 받기 어려워야 변별력이 생기며, 같은 조건에서 결과가 지나치게 흔들리지 않아야 합니다.

정답과 규칙이 분명한 항목은 프로그램으로 채점할 수 있습니다. 답이 열려 있는 문항은 기준표를 별도 채점 모델에 주고 평가하게 할 수 있습니다. 이때 시험을 보는 AI와 채점하는 AI는 분리해야 하며, 채점 기준과 모델 버전도 기록해야 전후 비교가 가능합니다.

점수는 왜 두 묶음으로 보나요?

한 번에 모든 사례를 고치려 하지 않고, 평가 결과를 보며 프롬프트와 라우팅을 한 가지씩 개선하는 과정을 hillclimbing이라고 합니다. 원문 사례는 전체 44건 중 탐색에 사용한 30건과, 탐색(튜닝) 과정에서 한 번도 보지 않은 14건(held-out)으로 나눴습니다. 탐색용 점수는 74.4%에서 98.9%로 올랐고, held-out 점수도 78.6%에서 90.5%로 올랐습니다.

탐색용 점수만 보면 문제를 외운 것처럼 좋아 보일 수 있습니다. 비용이 약 5분의 1로 내려간 이유도 함께 봐야 합니다. 시작은 Opus 4.8의 기본 high effort였고, 마지막은 Sonnet 5의 low effort였으며, 프롬프트와 라우팅 규칙도 개선됐습니다. 즉 모델 선택과 지시 설계를 같이 조정한 결과입니다.

학원 업무에는 어떻게 시작할까요?

상담 문의를 실제 사례에서 골라 답변의 합격 기준을 적고, 모의 상담 대화로 미리 시험해 보는 방식부터 시작할 수 있습니다. 워크북 검수라면 문항 연결, 사실 오류, 형식 누락을 각각 검사 항목으로 만들고, 사람이 최종 판단할 항목과 자동으로 확인할 항목을 나눕니다. 평가 결과가 낮은 이유를 기록하면 다음 개선의 방향도 분명해집니다.

원문에서 소개한 /claude-api build-eval과 /claude-api hillclimb 같은 흐름은 평가 사례를 만들고 개선을 반복하는 예입니다. 도구를 그대로 도입하기보다, 먼저 업무 사례·합격 기준·채점 방법·보류 조건 네 가지를 문서로 고정하는 것이 우선입니다.

eval을 설계하고 개선할 때 볼 것

  • 실제 상담·수업 자료에서 대표 사례와 어려운 사례를 함께 골라 평가 묶음을 만듭니다.
  • 정답형 검사는 규칙이나 프로그램으로, 열린 답변은 기준표 기반 채점으로 나눕니다.
  • 시험을 보는 AI와 채점하는 AI를 분리하고, 채점 조건을 기록합니다.
  • 튜닝에 쓰는 사례와 탐색 과정에서 보지 않는 사례를 분리합니다.
  • 한 번에 하나의 프롬프트·라우팅·모델 변경만 적용해 점수 변화를 비교합니다.
  • 점수뿐 아니라 실패 유형과 사람의 재검토 시간을 함께 기록합니다.

자주 묻는 질문

eval 사례는 몇 건이어야 하나요?

정해진 숫자부터 채우기보다 실제 업무의 변형과 위험을 골고루 포함하는 것이 먼저입니다. 사례가 적다면 결론을 확정하지 말고, 새로 생긴 실패를 평가 묶음에 추가하면서 범위를 넓히세요.

채점 모델은 시험 모델과 달라야 하나요?

중요한 평가에서는 분리하는 편이 좋습니다. 같은 모델이 만들고 스스로 합격을 선언하면 자기 결과를 후하게 볼 수 있으므로, 별도 채점 모델과 고정된 기준표를 사용하세요.

전후 점수가 올랐으면 바로 실전에 넣어도 되나요?

튜닝에 사용하지 않은 사례에서도 좋아졌는지 확인해야 합니다. 같은 채점 모델과 기준을 유지하고, 점수 외에 실제 검토 시간과 위험한 실패가 줄었는지도 함께 보세요.

hillclimbing은 모델만 바꾸는 과정인가요?

아닙니다. 프롬프트, 라우팅, effort, 모델 선택을 한 가지씩 바꾸며 평가를 높이는 과정입니다. 여러 변경을 동시에 적용하면 무엇이 개선을 만들었는지 알기 어렵습니다.

출처

이 글은 claude.dev 원문을 학원 운영 관점에서 요약·해설한 글이며 번역이 아닙니다.

AI가 같은 실수를 반복할 때는 스킬부터

한눈에 보기

  • 스킬은 지침·스크립트·자료가 든 업무 폴더
  • 설명은 언제 쓰는지 적기
  • 자주 틀리는 한 줄이 매뉴얼을 키운다

AI가 같은 실수를 반복한다면 모델을 바꾸기 전에 스킬을 만들어 보세요. 스킬은 지침만 적은 메모가 아니라 실행 스크립트와 참고자료까지 담아 필요할 때 꺼내 쓰는 업무 폴더이며, 자주 틀리는 한 줄을 다음 작업의 기준으로 남기는 장치입니다.

스킬에는 무엇을 넣나요?

Claude Code를 만든 경험을 다룬 원문에서 skill은 지침, 실행 스크립트, 참고자료가 함께 있는 폴더로 설명됩니다. 따라서 “이렇게 해”라는 문장만 넣는 것보다 업무에 필요한 파일과 반복 작업을 실행할 방법을 한곳에 두는 편이 낫습니다. 설명문은 사람에게 보이는 홍보 문구가 아니라, AI가 어느 상황에서 이 스킬을 불러야 하는지 알려주는 신호에 가깝습니다.

원문은 내부 스킬을 라이브러리·API 참고, 제품 검증, 데이터 조회·분석, 반복 업무 자동화, 코드 품질·배포 등 아홉 범주로 묶어 보여줍니다. 다만 이 분류가 모든 조직에 적용되는 확정 목록은 아닙니다. 학원이라면 수업 자료 제작, 상담 응대, 성적·출결 확인처럼 실제 반복 업무를 기준으로 자기 범주를 정하면 됩니다.

스킬이 무엇이고 첫 스킬을 어떻게 고르는지는 원장 머릿속 기준을 스킬로 옮기는 법에서 먼저 볼 수 있습니다.

gotchas는 왜 중요한가요?

gotchas는 “갓차”에 가깝게 발음하며, 자주 틀리지만 놓치기 쉬운 예외를 모아 둔 부분입니다. 예를 들어 추가만 되는(append-only) 구독 표에서 원하는 행은 만든 날짜(created_at)가 가장 최근인 행이 아니라 버전이 가장 높은 행입니다. 이런 한 줄은 긴 설명보다 실수를 잘 막을 수 있습니다. AI가 실제로 어디에서 헷갈렸는지 기록했다가 바로 이 구역에 추가하세요.

처음부터 거대한 매뉴얼을 쓰지 않아도 됩니다. 스킬 이름과 사용 조건 몇 줄, 첫 번째 gotcha 하나로 시작하고, 오류가 재현될 때마다 규칙을 보태면 됩니다. “무엇을 하는가”보다 “언제 써야 하는가”를 설명하는 것이 호출 시점을 안정시키는 데 더 중요합니다.

학원 업무에는 어떻게 옮길까요?

워크북 제작 스킬에는 자료 형식, 문항 연결 방법, 산출물 검사 순서를 넣을 수 있습니다. 상담 응대 스킬에는 개인정보를 다루는 범위, 사람에게 넘길 조건, 답변에 ‘확인되지 않음’을 표시하는 기준을 넣습니다. 이런 규칙을 매번 대화에 복사하는 대신 하나의 폴더와 참고자료로 관리하면 담당자가 바뀌어도 기준을 찾기 쉽습니다.

스킬은 AI를 마법처럼 똑똑하게 만드는 기능이 아닙니다. 이미 발견한 오류를 외부 문서로 기억하고, 다음번에도 같은 검사를 실행하게 하는 운영 장치입니다. 내용이 짧더라도 실제 실패를 정확히 막는 규칙 하나가 있으면 출발점으로 충분합니다.

학원 스킬을 만들고 고칠 때 확인할 것

  • 반복 업무마다 스킬의 이름, 호출할 상황, 끝난 상태를 한 줄씩 적습니다.
  • 지침뿐 아니라 필요한 스크립트와 참고자료를 같은 업무 폴더에 둡니다.
  • 최근에 발생한 실수를 gotchas에 재현 조건과 함께 기록합니다.
  • 워크북 제작과 상담 응대처럼 결과 기준이 다른 업무는 스킬을 분리합니다.
  • 답변에 ‘확인되지 않음’을 표시하는 기준처럼 사람이 검토할 신호를 명시합니다.
  • 실제 사용 뒤 호출되지 않은 경우와 잘못 호출된 경우를 모두 고쳐 씁니다.

자주 묻는 질문

스킬과 프롬프트는 무엇이 다른가요?

프롬프트는 한 번의 요청에 쓰는 지시문이고, 스킬은 지침·스크립트·자료를 반복해서 불러 쓰는 업무 단위입니다. 같은 절차를 여러 번 실행한다면 스킬로 외부화할 이유가 생깁니다.

gotchas에는 무엇을 적어야 하나요?

AI가 실제로 틀렸고 다음에도 다시 틀릴 가능성이 있는 예외를 적으세요. “주의해서 확인”처럼 넓은 말보다 어떤 값을 선택하고 어떤 순서를 지켜야 하는지 구체적으로 쓰는 편이 좋습니다.

설명문은 사람을 위해 쓰면 안 되나요?

사람이 읽을 수 있어야 하지만, 우선 AI가 사용 시점을 판단할 수 있어야 합니다. “상담 응대 스킬”보다 “학부모가 성적·보충수업을 문의할 때 사용”처럼 상황과 목적을 적는 것이 유용합니다.

아홉 범주를 모두 만들어야 하나요?

그럴 필요는 없습니다. 원문의 아홉 범주는 생각을 정리하는 참고 틀일 뿐이므로, 현재 반복되는 학원 업무 하나부터 스킬로 만들고 사용 기록을 보며 늘리세요.

출처

이 글은 claude.dev 원문을 학원 운영 관점에서 요약·해설한 글이며 번역이 아닙니다.

AI가 멋대로 일하지 않게 하는 안전장치

한눈에 보기

  • AI의 작업 순간에 끼어드는 mods
  • 위험한 일은 안전망과 권한 규칙으로 나누기
  • 내 업무의 금지 목록부터 적기

Claude Code의 mods는 AI가 명령을 실행하거나 응답하기 전후에 동작을 관찰하고, 내용을 바꾸거나, 다음 작업 대신 다른 응답을 돌려주는 맞춤 장치입니다. 학원 업무에서는 권한 규칙과 안전망을 나눠 설계하면 AI가 멋대로 진행하는 일을 줄일 수 있습니다.

mods는 무엇을 바꾸나요?

원문에서 mods는 플러그인 안에 넣는 자바스크립트·타입스크립트 모듈이며, 특정 이벤트에 반응하는 hook입니다. observe는 다음 동작을 그대로 진행시키면서 과정을 살펴보고, rewrite는 다음 명령이나 이벤트를 더 안전한 형태로 바꿉니다. answer는 단순히 거절하는 기능이 아닙니다. 다음 동작을 부르지 않고 직접 응답하므로, 요청을 막거나 다른 방법을 안내하는 데 쓸 수 있습니다.

이 기능은 Claude Code 2.1.287 이상(원문 게시 시점 기준)에서 사용할 수 있다고 소개됩니다. Token Weather처럼 컨텍스트 사용량을 보여주는 예, 위험 명령의 영향을 먼저 보여주는 Blast Radius, 작업 과정을 되짚는 Replay Theater가 원문에 나옵니다. 원하는 동작을 말로 설명해 초안을 만들 수 있다는 점도 진입 장벽을 낮춥니다.

안전망과 권한 규칙은 어떻게 나누나요?

여기서 가장 중요한 구분은 Blast Radius가 권한 시스템이 아니라 안전망이라는 점입니다. 실행 전에 위험을 보여주고 한 번 더 묻는 장치는 실수를 줄이지만, 특정 작업을 언제나 막아야 한다면 permission rules, 즉 권한 규칙으로 제한해야 합니다. “삭제는 승인 없이는 절대 실행하지 않는다”와 “삭제될 대상을 실행 전에 보여준다”는 서로 다른 층의 요구입니다.

mods는 Claude Code와 같은 권한으로 실행됩니다. 따라서 출처를 신뢰할 수 있는 장치만 설치하고, 무엇을 읽고 쓰는지 확인해야 합니다. 학원 자료를 다루는 경우에도 외부 공유·삭제·발송은 권한 규칙으로 좁히고, 파일명 정리나 작업 기록은 rewrite와 observe로 보조하는 식이 안전합니다.

학원 업무에 적용하면 무슨 소용인가요?

먼저 AI가 할 수 있는 일과 사람의 승인이 필요한 일을 한 줄씩 나눠 적습니다. 예를 들어 워크북 초안의 형식 점검은 자동으로 진행하되, 학생 정보가 들어간 파일의 외부 공유는 멈추게 합니다. 정보가 빠진 상담 문의에는 임의로 답을 만들지 않고 질문 목록을 돌려주도록 answer의 결과를 설계할 수도 있습니다.

처음부터 복잡한 장치를 만들 필요는 없습니다. 기록만 하는 단계로 어떤 명령이 반복되는지 살핀 뒤, 자주 위험해지는 지점에 수정이나 중단을 붙이면 됩니다. 안전망이 승인 절차를 대신하지 않는다는 원칙만 지키면 작은 학원에서도 범위를 정해 시작할 수 있습니다.

mods 도입 전 점검표

  • AI가 읽고·만들고·수정해도 되는 자료와 사람 승인이 필요한 자료를 분리합니다.
  • 삭제·외부 공유·발송처럼 반드시 막아야 하는 작업은 권한 규칙으로 제한합니다.
  • 처음에는 작업을 기록만 하며 반복되는 위험 명령과 누락을 찾습니다.
  • 파일명·출력 형식처럼 고쳐도 되는 입력은 rewrite의 대상으로 정합니다.
  • 자료가 없거나 판단이 필요한 요청에는 answer가 멈추고 질문을 돌려주게 합니다.
  • 설치한 mods의 출처와 필요한 권한을 확인하고, 변경 이력을 남깁니다.

자주 묻는 질문

mods와 permission rules는 무엇이 다른가요?

permission rules는 권한의 경계를 정하는 규칙입니다. mods는 그 경계 안에서 과정을 관찰하거나 입력을 고치고, 다음 작업 대신 응답하는 확장 장치입니다.

안전망이 있으면 위험한 작업을 허용해도 되나요?

안전망은 실수를 줄이는 보조 수단이지 승인 정책이 아닙니다. 반드시 막아야 하는 작업은 권한 규칙으로 차단하고, 안전망은 영향 범위와 확인 절차를 보여주는 데 사용하세요.

개발자가 아니어도 만들 수 있나요?

원문은 원하는 동작을 자연어로 설명해 초안을 만들 수 있다고 소개합니다. 다만 실제로 설치하기 전에는 코드가 접근하는 자료와 권한을 사람이 검토해야 합니다.

observe부터 시작하는 이유는 무엇인가요?

처음부터 작업을 바꾸면 정상 흐름까지 막을 수 있습니다. 기록으로 실제 패턴을 확인한 다음, 영향이 분명한 지점에 rewrite나 중단을 추가하는 편이 조정하기 쉽습니다.

출처

이 글은 claude.dev 원문을 학원 운영 관점에서 요약·해설한 글이며 번역이 아닙니다.