Jev 사용법: TypeSafe System One 모델 실전 가이드

TypeSafe AI의 Jev는 긴 문장을 생성하는 채팅 모델이 아니라, 프로그램 상태(state)와 타입 있는 질문을 받아 선택·점수·예/아니오 확률을 돌려주는 System One 모델이다. 이 글은 공개 실전 가이드 How to Use Jev: A practical guide to TypeSafe’s System One model의 구조를 바탕으로, moonlang에 이미 올린 소개 초안(WP 1704)과 공식·언론 교차 확인 범위 안에서 설정·세 프리미티브·다섯 패턴·실패 모드·언제 쓸지만 정리한다.

숫자 주의. 지연·가격 배수·벤치마크·“출시 48시간 데모” 비용은 대부분 TypeSafe 또는 데모 작성자 보고다. 가이드 본문도 자사 측정·미재현을 전제로 한다. 아래에서는 그 한계를 반복해 표시한다.

한 줄로

Jev는 state + 질문(Choice / Score / Noul)을 한 요청에 넣고, 수십~수백 밀리초 구간의 구조화 답을 받는 쪽에 가깝다. 텍스트·코드·요약을 “쓰게” 하는 도구가 아니다. 싸게 분류·라우팅·게이트한 뒤, 필요한 소수만 큰 LLM이나 사람에게 넘기는 캐스케이드가 실무 기본형이다.

Setup (가이드 기준)

키는 console.typesafe.ai/settings/keys(early access·웨이팅 가능) 또는 Vercel AI Gateway 경로를 가이드가 안내한다.

export TYPESAFE_API_KEY="sk-..."
  • Python 3.10+: pip install typesafe-sdk (또는 uv add typesafe-sdk)
  • Node 20+: npm install @typesafe-ai/sdk

가이드 기준 기본 모델은 jev-latest, HTTP는 POST https://api.typesafe.ai/v1/systemone. 패키지명·환경 변수명은 배포 시점에 바뀔 수 있으니 공식 문서와 콘솔을 한 번 더 확인한다.

회사·게이트웨이 쪽에 반복되는 입력 단가는 약 $0.042 / 1M input tokens, 출력 토큰 무료 주장이다. (Vercel AI Gateway 모델 카드·공식 소개와 동일 계열. 지속 가능 여부는 회사가 “장기 과제”로 남긴 바 있다.)

세 프리미티브

API의 질문 타입은 세 가지가 전부다. 우회할 제한이 아니라 설계 자체다. (공식 Primitives 문서와 동일 계열)

Choice — 집합에서 하나

Choice(
    instructions="Which team should handle this",
    criteria={
        "billing":   "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales":     "Pricing or account questions",
    },
)

.choice, .probabilities, .confidence를 돌려준다. 가이드는 옵션을 최대 255개까지, 짧은 숏리스트보다 전체 목록을 넘기라고 한다. 맞는 게 없을 때를 위해 명시적 other를 넣으라고 권한다.

Score — 스펙트럼 위 위치

Score(
    instructions="How frustrated the customer appears",
    criteria=[
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language",
    ],
)

2~10단계의 순서 있는 수준. .score는 단계 사이 값(예: 1.035)이 될 수 있고, 단계 인덱스는 배열 순서(0부터)다.

Noul — 예/아니오를 확률로

Noul(instructions="The message conveys urgency or time-sensitivity")

.noul은 0~1. 가이드 기준으로는 별도 confidence 필드가 없고, 숫자 자체가 믿음의 표현이다.

한 요청에 묶기

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()
response = client.system_one(
    state={
        "ticket": {
            "subject": "Duplicate charge",
            "messages": [
                {"from": "customer",
                 "text": "I was charged twice for order A-104. Please refund the duplicate."},
            ],
        },
        "order": {"id": "A-104", "charges": [
            {"amount_usd": 49, "status": "captured"},
            {"amount_usd": 49, "status": "captured"},
        ]},
        "refund_policy": "Duplicate charges are eligible for a refund.",
    },
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={"billing": "Payment or subscription issues",
                      "technical": "Bugs or integration problems",
                      "sales": "Pricing or account questions"}),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=["Calm, just stating facts",
                      "Frustrated but civil",
                      "Very angry, strong language"]),
        "refund_requested": Noul(
            instructions="The customer is explicitly asking for a refund"),
        "policy_supports": Noul(
            instructions="The stated refund policy covers this situation"),
    },
)

TypeScript 가이드 예시도 같은 모양이다. state는 문자열·객체·문자열 배열. 이미지·오디오·비디오는 없고, 필요하면 먼저 전사·캡션한다. 가이드가 적는 컨텍스트 한도는 대략 state+질문 합 64k, state+가장 긴 질문 32k 토큰(문서·버전과 다를 수 있음).

훔칠 만한 다섯 패턴

1) Speculative fan-out

질문은 병렬이라, “싼 호출 먼저 → 필요할 때만 후속” 본능을 뒤집는다. 카테고리와 무관해 보이는 후속 질문도 같이 묻고, 코드가 어떤 답을 쓸지 고른다. 가이드가 인용하는 TypeSafe 쿡북 주장: 위키 장문 위에 13질문을 한 번에 묶으면, 하나씩 물을 때보다 약 12.2× 싸고 10.0× 빠르며 답은 동일 — 자사 쿡북 수치다.

2) Confidence-gated routing

가이드는 Jev가 RLCD(Reinforcement Learning for Calibrated Decisions)로 확률을 결과에 맞춘다고 설명한다. (공식 소개는 보정된 결정 학습을 채팅용 RLHF와 대비한다.) 그래서 전역 임계값 하나보다, 행동 비용별로 다른 막을 둔다. 잔액 조회는 낮게, 이체 승인은 높게. 분포가 평평하면 모델보다 criteria 설계 문제인 경우가 많다.

3) Composite scoring

“이 지원자 얼마나 좋은가” 한 방 대신, 파이썬 깊이·리더십·시스템 설계처럼 원자 Score를 나눈 뒤 가중 평균은 코드에서 한다. 가중치 변경이 재프롬프트가 아니라 코드 변경이 된다.

4) Cascade
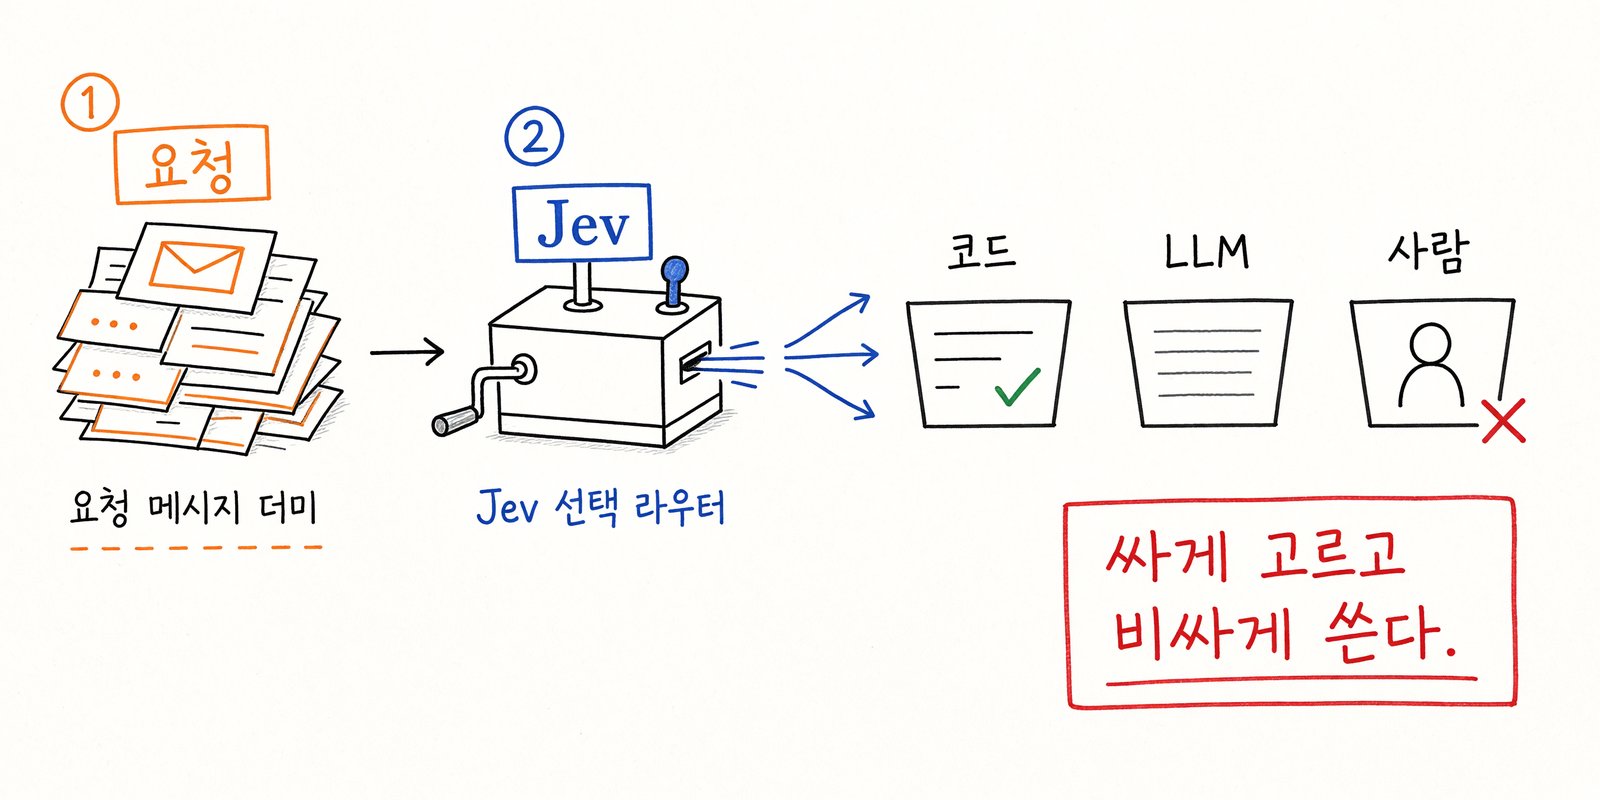
Jev Cascade: 코드·LLM·사람 분기
AI로 제작한 Cascade 흐름 안내 이미지

Jev는 Opus/GPT급을 대체하지 않는다. 누가 큰 모델을 받을지를 값싸게 고른다. intent+complexity로 나눈 뒤, 순수 코드 / 전문 LLM / 사람 에스컬레이션으로 분기. 가이드의 백만 티켓 비용 예시($6,480 vs $30,400 등)는 TypeSafe per-case 가정에 따른 산술 — 재현·트래픽 전제 없이 그대로 믿으면 안 된다.

5) Retrieve, then judge

Jev는 넘겨준 state 밖의 세계를 모른다. 관련 없는 텍스트를 넣으면 정확도가 떨어진다고 jaggedness/문서 계열에서 경고한다. 검색·필터는 코드(또는 검색 API)로 하고, 논문·패시지마다 Noul/Score로 값싼 판정만 맡긴다. “잘 보정된 잘못된 자료에 대한 판단”이 나올 수 있다.

다음에 읽을 글

Jev를 채팅이 아니라 게이트로 쓰기 — 영상 속 세 가지 패턴

Jev를 채팅이 아니라 게이트로 쓰는 영상 유스케이스를 Aside+Gmail·투자 봇·수능 라우터 패턴으로 정리한 저널입니다.

스토리에서 완성본까지: video-auto 영상 자동화 회고

에이전트 오케스트레이션과 외부 생성기로 멀티 씬 영상을 묶고, 유료·비가역 단계는 승인 게이트 뒤에 둔 회고입니다.

dif/context.json은 어떻게 움직이나 — Archify로 본 실험 스위치판

dif.sh에서 context.json이 빌드·런타임·에이전트에 어떻게 쓰이는지 Archify 워크플로로 풀어 쓴 글입니다.

출시 직후 데모 (참고만)

가이드는 2026-09-15 론칭 이후 약 48시간 산출물을 모았다. 작성자 자기 보고이며 프로덕션 사례가 아니다. 패턴만 요약한다.

  • 대량 논문: 생성 모델로 요약 + Jev Choice로 토픽 분류(비용 비대칭을 보여 주는 파이프라인).
  • 브라우저/컴퓨터 사용: 페이지·OCR을 기호 상태로 압축한 뒤 Jev가 행동·타깃을 고르고, 텍스트 입력 등만 작은 생성 모델.
  • 트레이딩·드론 등: 제어 루프·안전은 코드, Jev는 낮은 Hz의 전술 판단만.

공통점: 루프·안전·산술은 평범한 코드에 두고, 코드로 쓰기 어려운 좁은 판단만 Jev에 둔다.

실패 모드 (가이드·jaggedness 계열)

  • 글자 그대로 읽는다. 부정·범위·암시 조건이 곧이곧대로 적용된다. 틀린 답을 보고 “내가 진짜 뜻한 말”을 설명하게 되면, 그 설명이 빠진 instruction이다.
  • 계산기가 아니다. 세기·날짜 순서·창 안 여부 등은 약하다. 항목마다 Noul을 돌리거나, 날짜는 열거 Choice + “미기재”, 조립은 코드.
  • Context rot. 질문에 필요 없는 state가 늘수록 성능이 떨어진다. 먼저 회수·필터.
  • 적대적 state. 사용자 통제 텍스트가 스스로를 변호하면 답이 움직인다. 위협 모델은 애플리케이션 몫.
  • 모순된 criteria. true가 “아니오”를 뜻하는 Noul 등은 약해진다.
  • 생성 없음. 텍스트·코드·요약 불가. 후보는 정규식/생성 모델로 뽑고 Jev가 고른다.

메타 규칙: 코드가 정확히 계산할 수 있는 것을 모델에 묻지 말고, 한 질문에 여러 판단을 숨기지 말 것.

운영 메모 (가이드 시점)

  • 레이트 리밋 예시: jev-1.13 기준 초당 토큰·분당 요청 상한과 429 + SDK 백오프 — 용량에 따라 예고 없이 변할 수 있다고 TypeSafe가 경고.
  • 임계값을 튜닝했다면 jev-latest 대신 버전 핀. 응답의 model 필드를 로그.
  • 과금은 입력 중심·출력 무료 주장이라 speculative fan-out이 싸다는 논리다.

정직한 스코어카드

가이드가 인용하는 TypeSafe 4-워크플로 평가에서 Jev가 일부 프론티어와 비슷한 합의 점수·훨씬 낮은 비용/지연을 주장한다. 다만 (1) 정답이 아니라 두 프론티어 평균 레이블과의 합의도, (2) TypeSafe가 설계·실행한 자사 평가, (3) “환각 0%”는 스키마 밖 값을 못 낸다는 뜻이지 틀린 valid 답을 안 낸다는 뜻이 아님, (4) 가격 지속성은 증명되지 않음. 우리 트래픽으로 다시 재야 한다.

언제 쓰고 / 언제 안 쓰나

맞음: 라우팅·트리아지, 모더레이션, 비싼 컨텍스트 전 관련성 필터, LLM 출력 가드레일, 초저가 대량 태깅, 요청 핸들러 안 서브세컨드 판정.

아님: 생성 전반, 산술·카운트·날짜 연산, 감사 추적용 서술 근거가 필요한 결정, 열린 답 공간, 일회성 복잡한 추론.

싸진 LLM이 아니라, 타입을 반환하고 신뢰도를 말하는 함수 호출에 가깝다. 문자열 출력을 견디려고 쌓아 둔 파서·재시도 상당수를 걷어낼 수 있는지가 핵심 질문이다.

교육·문해력 쪽에서 보면

수업용 채팅봇 대체가 아니다. 다만 “한 방에 총평” 대신 기준을 Choice/Score/Noul로 쪼개고, 임계값 아래에서 사람이 개입하는 구조는 읽기 교육의 근거·판단 분리와 닮아 있다. 학생 산출물 자동 채점도 동일하게 문항 단위 판정 + 사람 게이트가 더 안전하다.

긴 글을 끝까지 읽는 습관·매체 선택은 초등 읽기: 종이 vs 태블릿에서, 시험 구간 유형 루틴은 수능 D-2 영어 유형 루틴에서 이어 읽을 수 있다. Jev 자체가 읽기 수업을 대체한다는 뜻이 아니다.

체크리스트

  1. 일이 유한 옵션·척도·예/아니오로 쪼개지는가.
  2. 틀린 결정을 잡을 임계값·에스컬레이션이 코드에 있는가.
  3. 산출물이 문장 자체면 LLM이 맞다.
  4. state는 최소·근거 있는 소스만 — 검색은 앞에서.
  5. 가격·지연·한도는 PoC와 게이트웨이 카드로 재확인. early access·모델 버전 변경을 전제한다.

FAQ

Q. Jev는 ChatGPT처럼 긴 글을 써 주는 모델인가요?
A. 아닙니다. 이 글 기준으로 Jev는 채팅·생성 모델이 아니라, state와 타입 있는 질문(Choice / Score / Noul)을 받아 선택·점수·예/아니오 확률을 돌려주는 System One 모델입니다.

Q. 언제 쓰고, 언제 안 쓰나요?
A. 맞음: 라우팅·트리아지, 모더레이션, 비싼 컨텍스트 전 관련성 필터, LLM 출력 가드레일, 초저가 대량 태깅, 서브세컨드 판정. 아님: 생성 전반, 산술·카운트·날짜 연산, 서술 근거가 필요한 감사형 결정, 열린 답 공간.

Q. “환각 0%”처럼 읽히면 틀린 답을 안 낸다는 뜻인가요?
A. 아닙니다. 가이드·스코어카드가 말하는 범위는 스키마 밖 값을 못 낸다는 쪽에 가깝고, 틀린 valid 답을 안 낸다는 뜻이 아닙니다. TypeSafe 자사 평가·합의도 한계도 본문에 적혀 있습니다.

Q. 본문의 지연·가격·벤치마크 숫자를 그대로 믿어도 되나요?
A. 대부분 TypeSafe 또는 데모 작성자 보고입니다. 가이드도 자사 측정·미재현을 전제로 합니다. 우리 트래픽으로 다시 재야 한다고 본문에 적었습니다.

Q. 교육·채점에 바로 써도 되나요?
A. 수업용 채팅봇 대체가 아닙니다. 기준을 쪼개고 임계값 아래에서 사람이 개입하는 구조, 문항 단위 판정 + 사람 게이트가 더 안전하다고 본문에 적어 두었습니다.

출처

  • 실전 가이드 원문 구조: How to Use Jev: A practical guide to TypeSafe’s System One model (사용자 제공; ai/llm/tutorial 태그)
  • 공식: typesafe.ai, Introducing System One Models & Jev (2026-09-15), docs.typesafe.ai
  • 교차: Business Wire / SiliconANGLE / Forbes The Prompt / The Register (2026-09-15~16), Cloudflare Workers AI·Vercel AI Gateway 모델 카드
  • 관련 moonlang 초안: TypeSafe AI와 Jev 소개 (WP 1704, draft)

다음에 읽을 글

Jev를 채팅이 아니라 게이트로 쓰기 — 영상 속 세 가지 패턴

Jev를 채팅이 아니라 게이트로 쓰는 영상 유스케이스를 Aside+Gmail·투자 봇·수능 라우터 패턴으로 정리한 저널입니다.

스토리에서 완성본까지: video-auto 영상 자동화 회고

에이전트 오케스트레이션과 외부 생성기로 멀티 씬 영상을 묶고, 유료·비가역 단계는 승인 게이트 뒤에 둔 회고입니다.

dif/context.json은 어떻게 움직이나 — Archify로 본 실험 스위치판

dif.sh에서 context.json이 빌드·런타임·에이전트에 어떻게 쓰이는지 Archify 워크플로로 풀어 쓴 글입니다.

필기만 지우고 인쇄는 남긴다: CleanScan(교재 스캔) 실험 회고

필기만 마스크로 지우고 인쇄 원본은 남기는 CleanScan 손그림 안내
AI로 제작한 손그림 안내 이미지

학원·학교에서 가장 흔한 스캔 요청 중 하나는 이것이다. “시험지·프린트에 쓴 필기를 지우고, 인쇄된 글자는 그대로 두고 싶다.” 시중 스캐너 앱은 곡면 보정·OCR에는 강하지만, 필기 제거 과정에서 인쇄 글자를 다시 그려 버리는 경우가 있다. 시험지 재사용에는 치명적이다.

ocr-scanner-fable 작업(제품 가칭 CleanScan / CleanScan)은 그 문제를 Web 우선 파이프라인으로 풀어 본 기록이다. 이 글은 기획서·마일스톤 로그에 남은 결정과 교훈만 요약한다. 벤치마크 앱의 다운로드 수 등은 기획 조사에 인용된 참고치이며, 우리 제품의 성과 지표가 아니다.

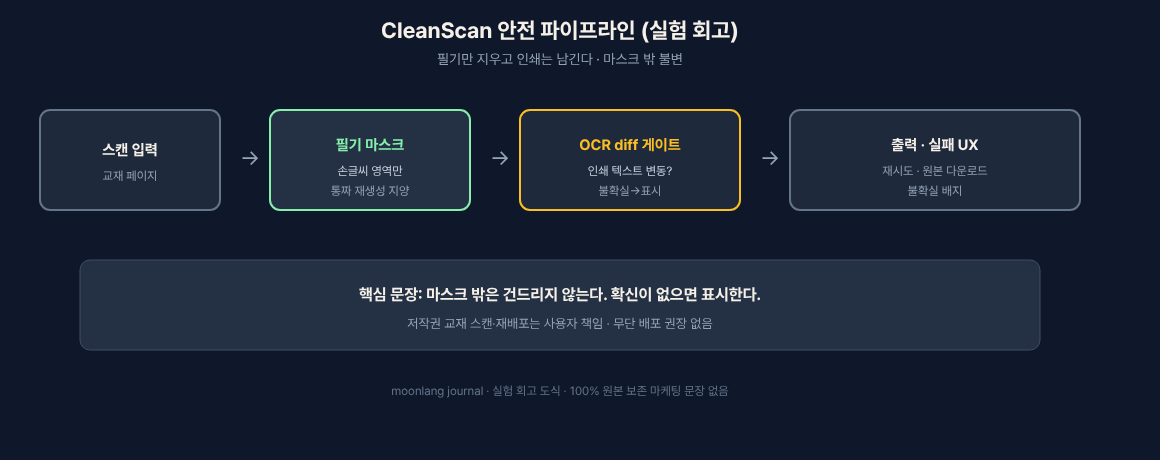
CleanScan 안전 파이프라인: 스캔 입력 → 필기 마스크 → OCR diff 게이트 → 출력·실패 UX
CleanScan 안전 파이프라인 — 마스크 밖 불변 · 실험 회고 도식

제품 한 줄

교재·시험지·프린트를 올리면 필기·낙서만 지우고 인쇄 원본을 복원하는 스캐너. OCR은 후속 단계로 두고, 1차 가치는 원본 픽셀 충실도에 둔다.

왜 생성형 “통짜 편집”을 기본으로 두지 않았나

기획 비교에서 생성형 이미지 편집 API는 MVP가 빠르지만, 문서 전체를 재생성하며 인쇄 글자를 치환·변형할 수 있다. 그래서 권장 골격은 하이브리드였다.

  1. 경계 감지·원근 보정
  2. 필기 마스크 (고전 CV + 세그멘테이션)
  3. 마스크 안만 인페인팅 (기본 LaMa, 실패 시 TELEA 폴백)
  4. 마스크 밖 픽셀은 수정하지 않는다

이 문장이 전 아키텍처의 중심이다.

파이프라인에서 배운 안전장치

마일스톤 로그에 남은 실전 교훈을 짧게 옮긴다.

불확실 영역 표시 LaMa는 필기 아래 인쇄 글자를 “그럴듯한 오탈자”로 채워 넣을 수 있다. 충실도 OCR 게이트는 마스크 *안쪽*을 측정하기 어렵다. 그래서 복원 불확실 구간을 계약 필드와 앰버 하이라이트로 노출했다. “깨끗해 보이는 결과”보다 어디를 믿으면 안 되는지를 보여 주는 쪽을 택했다.

마스크 커버리지 상한 실스캔에서 오검출이 커지면 본문까지 지워진다. 커버리지 상한(의심 마스크)과 원본 보존 경로를 넣어, 파괴적 결과를 차단하는 실험을 했다. 로그상 오검출이 크게 줄고 본문 보존이 확인된 사례가 있다. 굵은 헤더 오검출·잔여 필기는 이후 과제로 남겼다.

데모와 mock을 섞지 않기 UI mock만으로는 “필기 제거가 안 된다”는 피드백을 재현할 수 없다. 워커 FastAPI 직결 로컬 데모 브리지를 두고 나서야 브라우저 e2e로 원자적 JSON 쓰기·폴링 내성 같은 결함을 잡았다.

계약(versioned job schema) UUID·상태 전이·soft error·uncertain_regions 등을 버전으로 고정하고, 구세대 산출물은 폐기 세대로 격리했다. UI·워커·QA가 같은 언어로 실패를 말하게 하려는 목적이다.

교육 현장 관점

  • 학원 배치: 같은 시험지 PDF를 다시 쓰려면 “예쁜 복원”보다 “인쇄 동일성”이 먼저다.
  • 학생 오답 노트: 필기 제거 후 OCR·문항 클립은 P1 이후 스토리다. 너무 일찍 묶으면 충실도 문제가 가려진다.
  • 윤리: 저작권 있는 교재 스캔·재배포는 사용자 책임 영역이다. 도구는 복원 보조이며, 무단 배포를 권장하지 않는다.

지금 단계의 한계

  • Web MVP·로컬 워커 중심. Android 연속 촬영은 후속.
  • 실스캔 다양성(조명·볼펜·형광펜·겹친 글씨)은 여전히 꼬리다.
  • “100% 원본 보존”을 마케팅 문장으로 쓰지 않는다. 대신 OCR diff 게이트·불확실 영역 같은 검증 장치를 제품 언어로 남긴다.

다음에 같은 스캐너를 만든다면

  1. 마스크 밖 불변식 테스트부터 자동화한다.
  2. 실패 UX(재시도·원본 다운로드·불확실 배지)를 모델 교체보다 먼저 둔다.
  3. 교육용 배치(여러 장 → PDF)는 충실도 리포트와 함께 출시한다.

필기 제거는 이미지 미화가 아니라 문서 신뢰 문제다. CleanScan 실험이 남긴 가장 큰 문장은 여전히 이것이다. 마스크 밖은 건드리지 않는다. 확신이 없으면 표시한다.

FAQ

Q. 생성형으로 페이지 전체를 다시 그리는 방식이 기본인가요?
A. 이 회고 기준으로는 기본으로 두지 않았습니다. 필기 마스크 안에서만 지우고 인쇄 영역은 건드리지 않는 쪽을 안전장치로 둡니다.

Q. “원본 100% 보존”이라고 말해도 되나요?
A. 마케팅 문장으로 쓰지 않습니다. 대신 OCR diff 게이트·불확실 영역 표시 같은 검증 장치를 제품 언어로 남깁니다.

Q. 교재 스캔을 자유롭게 재배포해도 되나요?
A. 안 됩니다. 저작권 있는 교재 스캔·재배포는 사용자 책임이며, 도구는 복원 보조일 뿐 무단 배포를 권장하지 않습니다.

Q. 지금 단계에서 완전한 Android 연속 촬영 제품인가요?
A. 아닙니다. Web MVP·로컬 워커 중심이고 Android 연속 촬영은 후속으로 적혀 있습니다.

작성: moonlang journal · polish 2026-09-23 · 저작권·100% 보존 마케팅 문장 없음

한국어 관용구 220항목 × 5포맷: 학습 자료 뱅크를 만든 이유

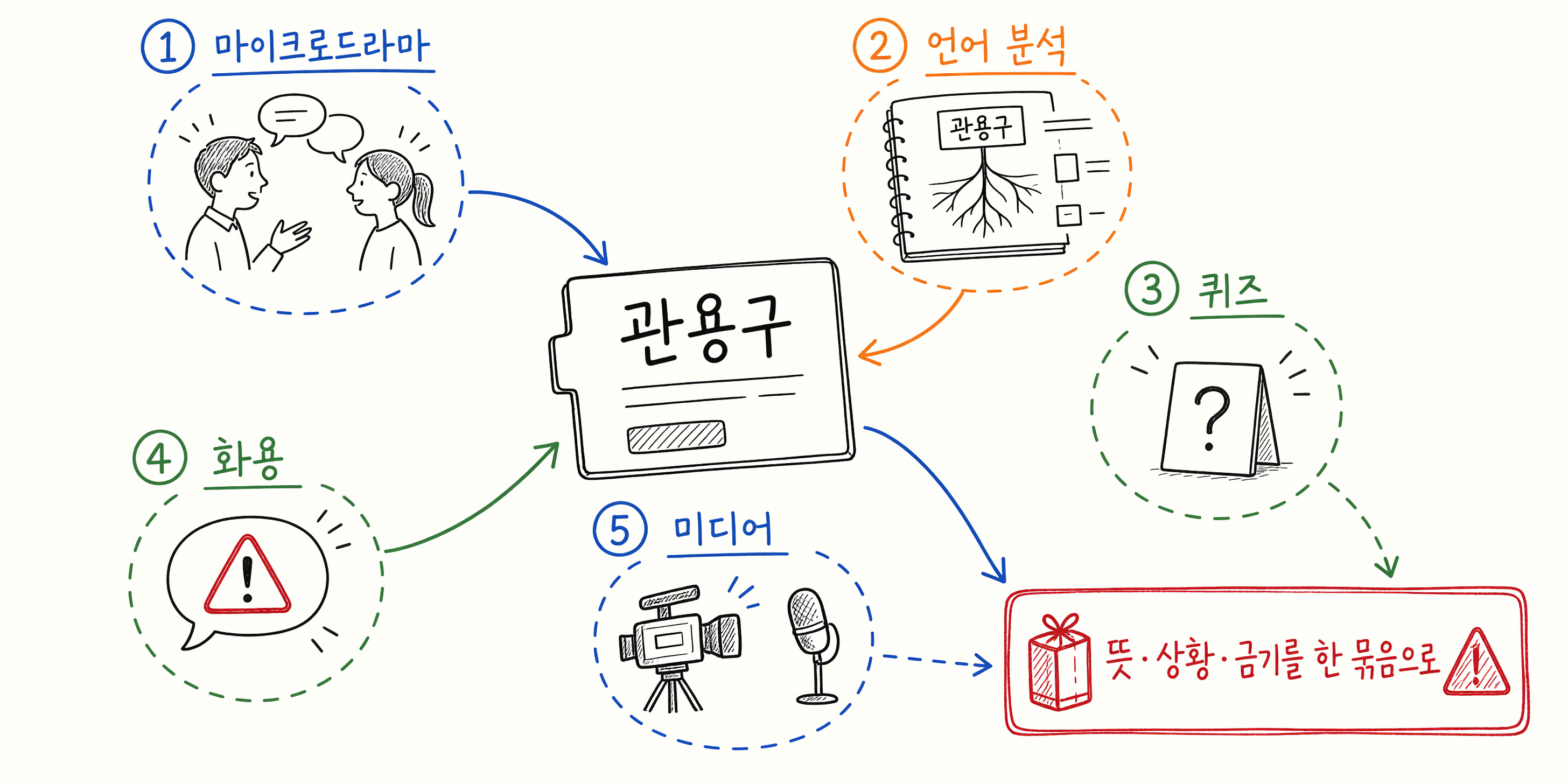
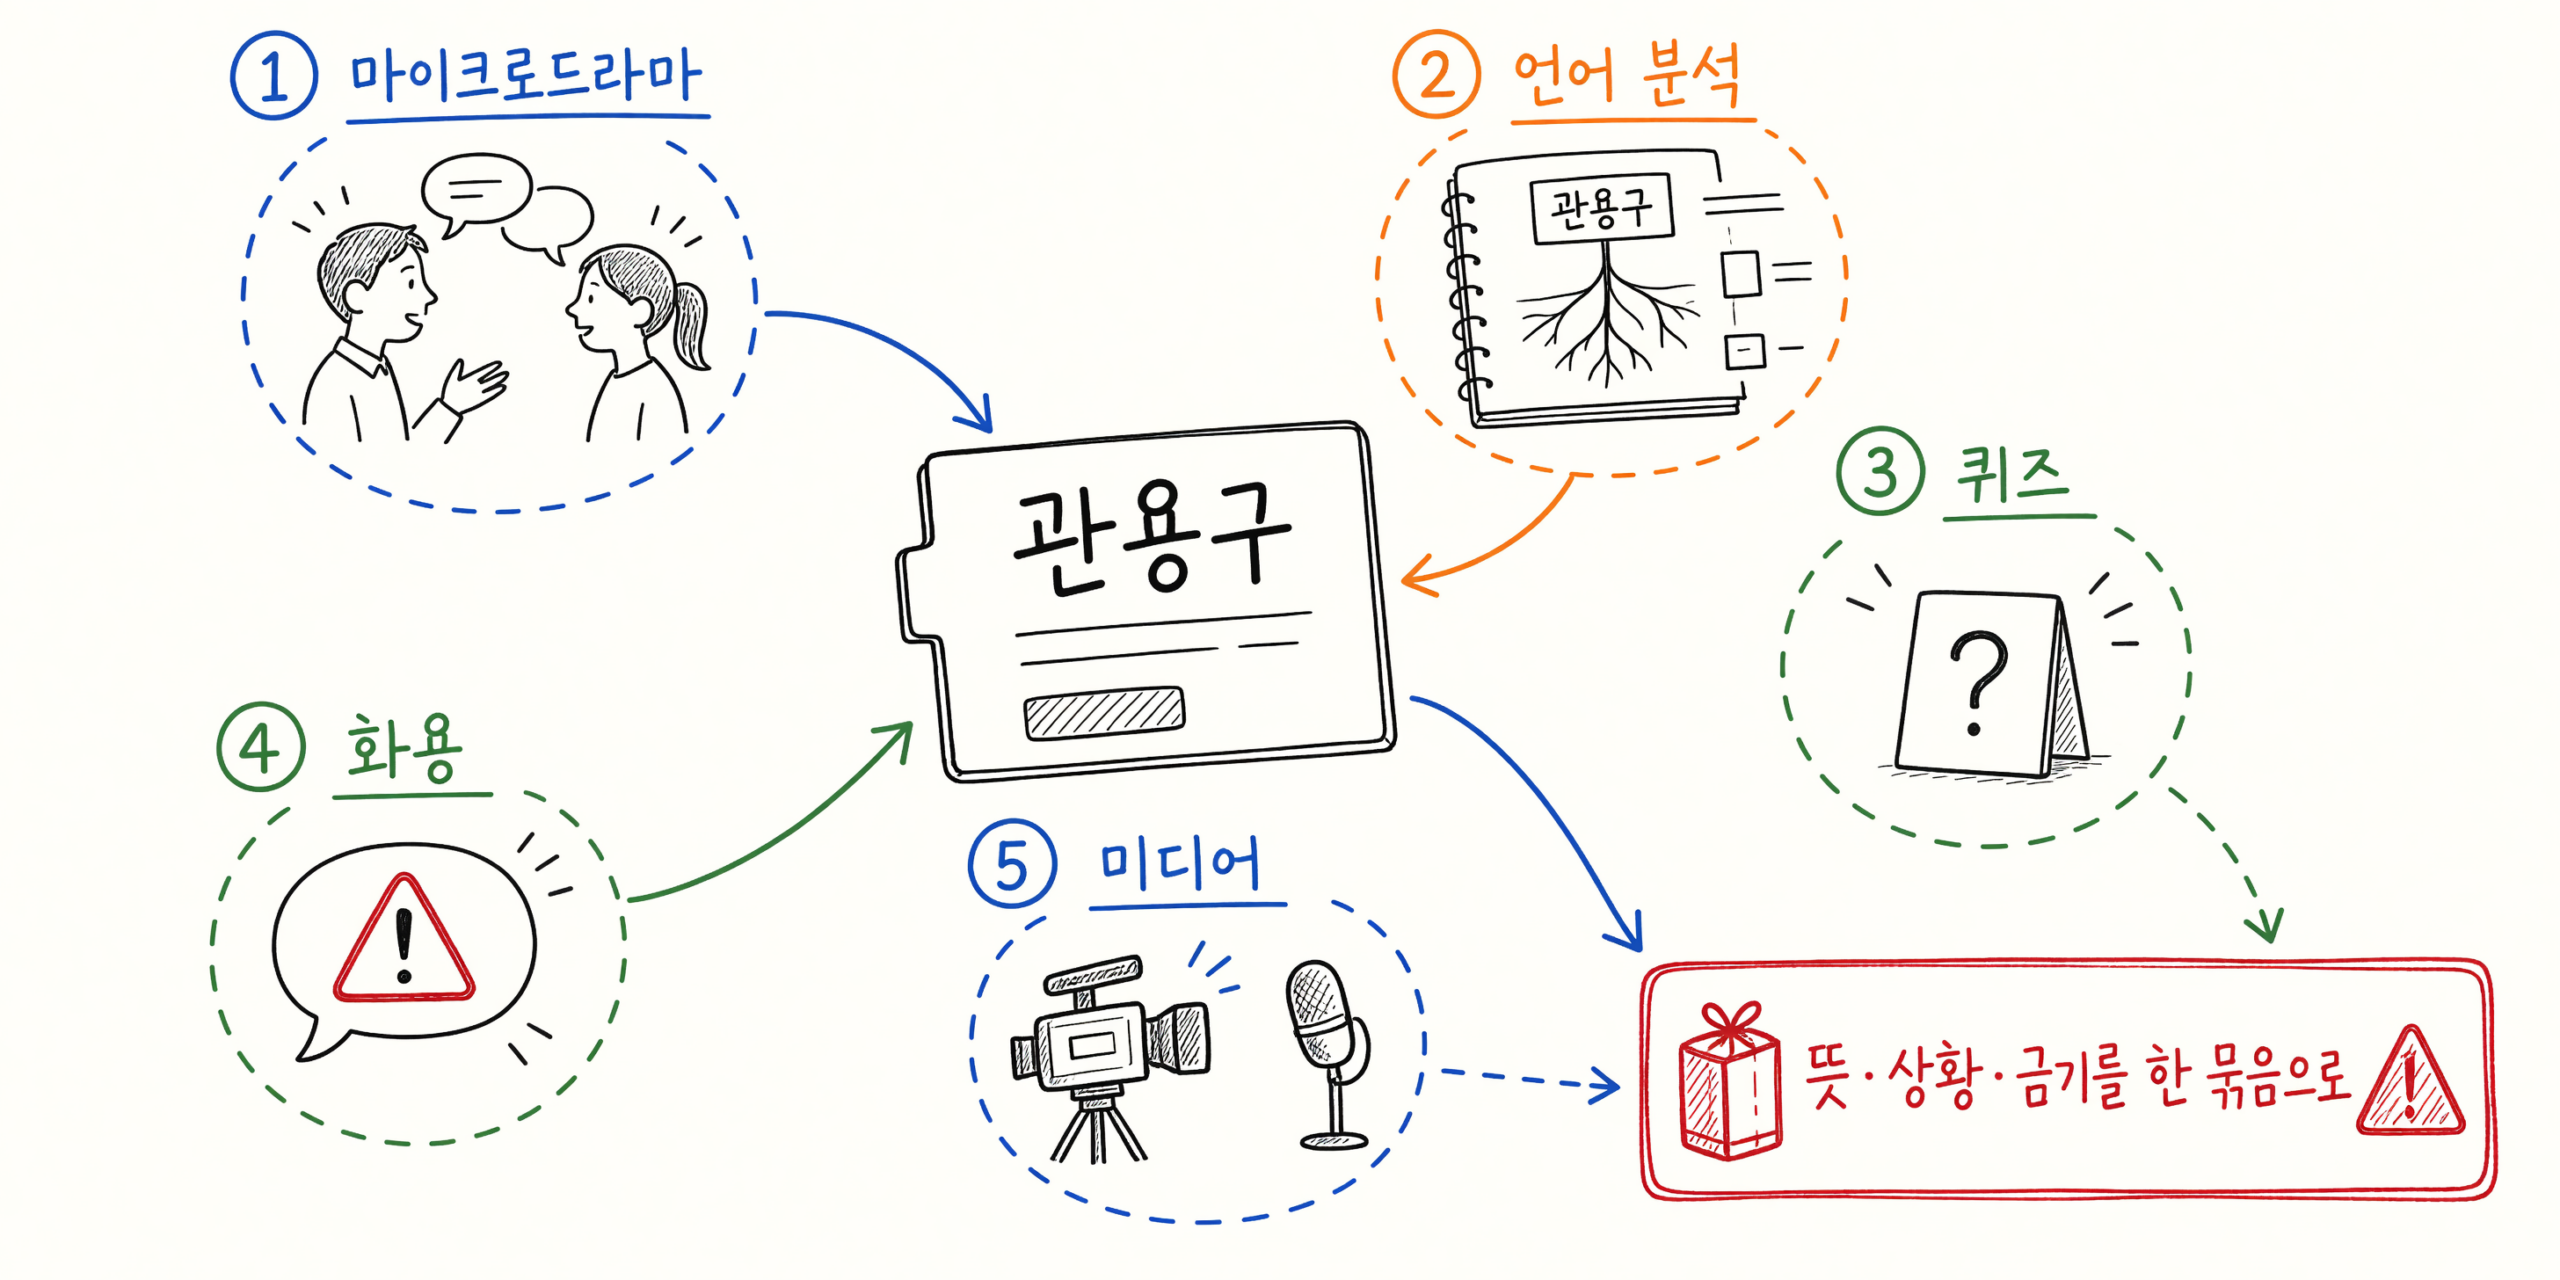
관용구 한 장이 드라마·분석·퀴즈·화용·미디어 다섯 포맷으로 펼쳐지는 손그림 안내
AI로 제작한 손그림 안내 이미지

외국인 학습자에게 속담·관용구를 “뜻 한 줄”로만 주면, 시험에서 고를 수는 있어도 대화에서 쓰지 못한다. 반대로 예문만 잔뜩 있으면 핵심 의미와 금기(언제 쓰면 失礼인지)가 묻힌다. korean-idioms 프로젝트는 그 간극을 메우기 위해, 항목마다 같은 스키마의 다섯 포맷을 묶은 콘텐츠 뱅크를 만들었다.

이 글은 공개 가능한 구조와 설계 원칙만 정리한다. 개별 문항 전문을 여기에 복제하지 않는다.

무엇이 쌓였는가

README 기준 규모는 다음과 같다.

  • 220개 표제어 (속담 84 · 관용구 56 · 사자성어 40 · 의성·의태어 40)
  • 표제어당 5포맷: 마이크로드라마 · 언어 분석 · 퀴즈 · 화용(쓰임) · 미디어 제작 사양
  • 합쳐 텍스트 자산 약 1,100개 단위 (대본 턴·문항·분석 카드·화용 노트·미디어 스펙을 포함)

앱은 Next.js로 번들(workspace/bundles/*.json)을 읽고, Supabase 키가 있으면 DB로 전환한다. 키가 없어도 로컬 번들로 동작하게 해 두었다.

왜 ‘한 사전 항목’이 아니라 ‘5포맷 번들’인가

학습자가 실제로 막히는 지점이 포맷마다 다르기 때문이다.

포맷 · 학습자가 얻는 것

마이크로드라마 · 상황·말차례 안에서 표현이 나오는 감각

언어 분석 · 구성, 유의·반의, 함정(literal trap)

퀴즈 · 이해 점검 (정답만 외우지 않도록 설계)

화용 · 누가·언제·얼마나 공손한지, 피해야 할 맥락

미디어 사양 · 이미지·TTS 등 후속 제작을 위한 텍스트 스펙

예: 「가는 말이 고와야 오는 말이 곱다」는 뜻이 쉬워 보여도, 직역 함정과 사용 역(register)을 같이 적지 않으면 “그냥 착하게 말하자” 수준으로 납작해진다. 번들 필드에 literal_trap, register, caution 등을 둔 이유다.

설계 원칙 두 가지

1) 주의 항목은 삭제하지 않고, 맥락과 함께 남긴다. 계급·체념을 정당화해 온 이력이 있는 속담은 다섯 포맷 모두에 “옛 표현이며 오늘날에는 반박·주의가 따른다”는 정보를 넣는다. caution_note가 비면 마스크·검증에서 거부되도록 했다. 검열이 아니라 설명 책임에 가깝다.

2) unresolved는 실패가 아니라 정직성 기록이다. 실사용 빈도를 확신할 수 없거나, 어원을 지어내고 싶지 않거나, 원어민도 잘 구분해 쓰지 않는 쌍은 억지로 “정설”을 만들지 않고 unresolved로 남긴다.

생성 파이프라인은 레인(lane) 출력 → 마스크 감사 → reduce 병합 → Zod 검증 순이다. 미디어 실물화(이미지·TTS)는 별도 하네스(idiom-media-realize)로 분리했고, 파일럿은 일부 항목(KI-001~005)부터 이미지를 붙이는 방식으로 진행했다.

교실·자습에서 쓰는 법 (제안)

  1. 의미 확인은 언어 분석 카드만 보지 말고, 마이크로드라마 한 장면을 먼저 읽는다.
  2. 퀴즈는 틀린 보기 이유를 화용 노트와 대조한다.
  3. 주의 깃발이 있는 항목은 “시험용 뜻”과 “지금 말해도 되는 말”을 구분해 지도한다.
  4. 교육용으로 쓸 때는 번들을 그대로 대량 복제·재배포하지 말고, 필요한 항목만 수업 시트에 맞게 재구성한다.

이 글에서 하지 않는 말

  • 수강 성과·점수 향상 보장
  • 검증되지 않은 “원어민 사용 빈도 순위”
  • 어원을 단정한 설화

관용구 교육의 난점은 데이터 양이 아니라, 뜻·상황·금기를 같은 묶음으로 유지하는 일에 있다. 220×5 뱅크는 그 묶음을 스키마로 고정해 둔 작업 기록이다.

스토리에서 완성본까지: video-auto 영상 자동화 회고

스토리에서 완성본까지 이어지는 영상 자동화 체인 손그림 안내
AI로 제작한 손그림 안내 이미지

짧은 영상을 “한 번 생성”하는 도구는 많다. 어려움은 그다음이다. 장면이 이어져야 하고, 캐릭터·배경이 흔들리면 안 되며, 비용·승인·실패 재시도가 파이프라인 안에 있어야 한다. video-auto(Chained Video Studio) 작업은 그 문제를 에이전트 오케스트레이션 + Electron 도구 + 외부 생성기로 나눠 붙잡은 실험이다.

이 글은 출시 후기가 아니라, 로컬 저장소에 남은 운영 계약과 검증된 산출물 기준으로 적은 회고다. 성과 수치나 미공개 API 키는 쓰지 않는다.

한 줄로 말하면

코딩 에이전트가 지능(오케스트레이터·디렉터·리뷰어)을 맡고, Electron/Node는 도구와 상태만 제공한다. 미디어는 Grok Imagine, Google Flow(Gemini Flow), Kling 등 외부 제공자가 만들고, 이 앱은 체인(순서·게이트·체크포인트) 을 소유한다.

Sora는 경로에서 제외했다. 제공자 표는 README 기준으로 grokWeb / grokApi / geminiFlow / klingApi / klingFal / klingWeb이다.

두 개의 제어면

CLAUDE.md가 못을 박아 둔 경계가 있다.

일 · 하네스 · 진입점

멀티 씬 필름 제작 · Claude production skills · shot-studio (plan → assets → render → post)

Electron 앱 코드 변경 · 앱 개발 하네스 · AGENTS.md → harness manifest

유료·비가역 단계(렌더 등)는 shot-studio 승인 게이트 뒤에 둔다. shot-plan 등을 직접 호출해 게이트를 우회하지 않는다.

병렬로 OpenMontage 흡수형 /video 경로도 있다. research·prompts·QA는 팬아웃하고, last-frame 릴레이만 순차로 두는 하이브리드다. 보드·체크포인트·코스트 스크립트(om:*)가 “지금 어느 스테이지인지”를 사람에게 보여 준다.

실제로 남긴 것

문서에 적힌 검증 산출물 예시는 다음과 같다.

  • 최종 컷: runs/chain/black-file-twelve-faces/out/...-final-cut.mp4
  • 프로덕션 레저: 同 프로젝트 ledger.json
  • 편집 가능한 타이틀 AEP
  • 두 번째 검증 레저: runs/chain/skyduel/ledger.json

즉 “데모 GIF 한 장”이 아니라, 런 디렉터리 + 레저 + 게이트가 남는 구조를 목표로 했다.

스토리 → 영상 E2E는 대략 이런 명령으로 묶인다.

npm run produce -- --story "..." --scenes 6 --yes --provider grokWeb
npm run produce:status -- --project <projectId>
npm run produce:stitch -- --project <projectId>

Three.js를 본선으로 쓰지 않은 이유

선택지 제목에 “Three.js 렌더”가 있었지만, video-auto 본 저장소의 중심은 생성형 비디오 체인 + ffmpeg 스티치 + 에이전트 게이트다. Three.js/WebGL 언급은 관련 학습 스펙 문서에 스치듯 나타날 뿐, 프로덕션 경로의 기본 렌더러로 고정되어 있지 않다. 회고에서 과장하지 않기 위해 본선은 체인 자동화로 적는다.

배운 점

  1. 파이프라인 없는 생성은 재현되지 않는다. Rule Zero — 모든 프로덕션은 manifest 스테이지를 탄다.
  2. 병렬과 순차를 섞어야 한다. 이미지·리서치는 병렬, 컷 연속성(릴레이)은 순차.
  3. 비용·연속성 게이트를 스킬 밖에 두면 반드시 우회된다. 진입점을 shot-studio 하나로 모은 이유다.
  4. 사람에게는 보드가 필요하다. dry-run·gate·ship 샘플이 온보딩을 대신한다.
  5. 캐릭터/월드 락 없이 씬을 늘리면 얼굴과 소품이 먼저 붕괴한다.

한계

  • 브라우저 로그인 기반 제공자(grokWeb 등)는 세션·UI 변경에 취약하다.
  • 외부 API 요금·쿼터는 레저로 추적해도 “창작 품질”을 보장하지 않는다.
  • Electron 앱 UX와 에이전트 스킬이 이중으로 있으면, 문서가 어긋날 때 드리프트가 생긴다. 변경 이력표를 CLAUDE/AGENTS에 남긴 이유다.

다음에 같은 일을 한다면

  1. 스토리 입력 → plan-only로 SCENE_TABLE 승인 → 그다음 gen.
  2. provider는 한 프로젝트에 하나만 기본값으로 고정하고, 폴백은 명시적 게이트 뒤에.
  3. 최종물은 mp4만이 아니라 ledger + review 아티팩트를 함께 아카이브.

영상 자동화의 핵심은 모델 이름이 아니라, 에이전트가 같은 계약을 다시 실행할 수 있는가에 있었다.

DESIGN.md에서 Tailwind까지: 디자인 스펙을 코드에 붙인 회고

DESIGN.md 스펙을 Tailwind 테마로 옮기는 손그림 과정 안내
AI로 제작한 손그림 안내 이미지

코딩 에이전트에게 “예쁜 UI”를 맡기면 결과는 매번 조금씩 달라진다. 같은 브랜드인데도 버튼 색, 여백, 타이포가 세션마다 흔들린다. google-design-2026 작업에서 붙잡은 질문은 단순했다. 디자인을 에이전트가 다시 읽을 수 있는 하나의 문서로 고정할 수 있는가?

이 글은 Google의 DESIGN.md 형식과, 그 스펙을 Tailwind 테마·토큰으로 옮긴 로컬 워크플로를 정리한 회고다. 제품 출시 공지가 아니라, 실제로 무엇을 남기고 무엇을 버렸는지에 초점을 둔다.

DESIGN.md가 하려는 일

DESIGN.md는 시각 아이덴티티를 코딩 에이전트에게 설명하기 위한 포맷이다. 파일은 두 층으로 나뉜다.

  1. YAML 프론트매터 — 색, 타이포, rounded, spacing, 컴포넌트 토큰처럼 기계가 읽을 값
  2. 마크다운 본문 — 그 값이 *왜* 존재하는지, 어디에 쓰고 어디에 쓰지 않는지

공식 README의 요지는 명확하다. 토큰은 정확한 값을 주고, 산문은 적용 방식을 준다. 에이전트가 이 파일을 읽으면 “딥 잉크 헤드라인 + 따뜻한 석회 배경 + 단일 액센트 CTA”처럼 한 세트의 판단으로 UI를 맞출 수 있다.

철학 문서가 더 강하게 말하는 지점도 있다. 문장(의도)의 질이 숫자 정밀도보다 생성 품질을 좌우한다. “모던하고 신뢰감 있는 프리미엄” 같은 형용사 나열보다, “오래된 대학의 대학원 세미나 유인물”처럼 구체적 참조 한 줄이 여백·잉크·장식 금지를 함께 실어 나른다. 무엇을 빼는지가 캐릭터를 만든다.

로컬에서 한 일 (워크플로)

로컬 design.md 모노레포는 CLI·린터·예시(DESIGN.md + Tailwind config + DTCG JSON)를 한곳에 두었다. 실무에서 반복한 흐름은 대략 이렇다.

  1. 의도 먼저 쓰기 — Overview에 참조 세계와 Don’ts를 적는다.
  2. 토큰을 프론트매터에 고정 — primary/secondary/neutral, 타입 스케일, spacing.
  3. npx @google/design.md lint — 깨진 참조, 구조, WCAG 대비 등을 JSON finding으로 받는다.
  4. Tailwind로보내기 — 예시처럼 tailwind.config / design tokens JSON으로 옮겨 유틸리티가 같은 이름을 쓰게 한다.
  5. diff로 회귀 감지 — 토큰·산문 변경이 “조용한 브랜드 붕괴”인지 확인한다.

중요한 운영 규칙 하나: 토큰을 “렌더 명령서”로 과대 해석하지 않는다. 스펙 쪽 관점도 토큰은 맥락이고, 산문이 디자인이다. Tailwind는 그 맥락을 빌드 타임에 붙잡는 다리일 뿐이다.

잘 된 점

  • 세션 간 드리프트가 줄었다. 에이전트에게 “이 DESIGN.md를 따르라”고 하면, 색·타입의 중심이 문서에 남는다.
  • 리뷰 언어가 생겼다. “느낌이 다르다” 대신 lint finding·token diff로 말할 수 있다.
  • 예시 세트(예: Atmospheric Glass)가 온보딩을 짧게 만든다. DESIGN.md → Tailwind → DTCG JSON이 한 폴더에 있으면 설명 비용이 떨어진다.

깨진 점 / 주의

  • 형용사만 채운 DESIGN.md는 무용하다. lint를 통과해도 산문이 비면 결과물은 다시 중간값 UI로 돌아간다.
  • 컴포넌트 토큰을 Tailwind에 전부 밀어 넣으면 유틸리티 철학과 충돌한다. 예시 README도 컴포넌트 토큰은 JSON 쪽에 두고, Tailwind는 프리미티브에 집중하는 편을 택한다.
  • 에이전트는 Don’ts를 잊기 쉽다. 산문에 금지를 쓰고, 체크리스트로 한 번 더 고정하는 편이 안전하다.
  • 이 글은 Google 공식 제품 로드맵을 대변하지 않는다. 로컬에서 스펙을 읽고 적용해 본 작업 노트다.

다음에 남길 체크리스트

  1. Overview에 구체적 참조 세계가 있는가.
  2. 색·타입·spacing 토큰 이름이 산문과 같은 어휘인가.
  3. lint를 돌렸고, 대비·깨진 참조를 처리했는가.
  4. Tailwind theme이 프론트매터와 이름 단위로 맞는가.
  5. 변경 시 diff로 회귀를 남겼는가.

디자인을 “예쁜 스크린샷”이 아니라 에이전트가 다시 실행할 수 있는 계약으로 두는 것. DESIGN.md → lint → Tailwind 연결은 그 계약을 짧고 검증 가능하게 만드는 한 가지 방법이었다.

중·고 국어 고전, 집에서 작품 고를 때 뭘 먼저 보면 되나요? — 청소년 고전 가이드

중·고 국어 고전, 집에서 작품 고를 때 뭘 먼저 보면 되나요?

작품마다 다른 질문
AI로 제작한 읽기 안내 이미지

줄거리 요약보다 읽기 기술 목표 · 연령·수위 · 판본(원문/주석/발췌) 세 가지를 먼저 맞춘 뒤, 아래 작품별 가이드로 들어가세요. 각 URL은 한 작품의 질문 하나에만 답합니다. 성적·적중·1위·합격 약속은 하지 않습니다.

Fits / 미룸

Fits 중·고 국어 고전을 작품마다 다른 출발점으로 집에서 고르고 싶을 때
미룸 한 권 줄거리만 급할 때 / 내신·대학 보장을 원할 때

고르는 기준 3

  1. 연습할 읽기 기술(시점·수위·신분·가족 화자·권력 우화 등)이 집 목표와 같은가
  2. 권장 연령·수위가 우리 아이에게 맞는가
  3. 원문·주석본·발췌 중 무엇을 쓸지 정해 두었는가

학원 정보

리드마스터 영어전문 국어논술 학원
경기도 부천시 소사구 옥길로 113, 상림프라자 5층 501호
전화 010-3368-7873
다음 단계(선택): 레벨테스트

시리즈 출처 정책

각 작품 글은 그 글이 실제로 쓴 출처만 적습니다. 대학 태그만 있고 목록명·연도가 없으면 추정으로 보고 빼거나 한계를 밝힙니다. 가짜 별점이나 성적을 약속하는 문장은 쓰지 않습니다.

학부모 입구로 먼저 볼 예

작품별 가이드

자주 묻는 질문

Q. 요약 사이트와 뭐가 다른가요?
A. 줄거리 덤프가 아니라 집에서 뭘부터 읽히는지에 답합니다.

Q. 학원 등록이 필수인가요?
A. 아닙니다. 가이드는 공개 읽기 안내입니다. 진단·수업이 필요할 때만 다음 단계를 보세요.

Q. 성적을 보장하나요?
A. 아닙니다. 보장·적중·1위 문구는 쓰지 않습니다.

Q. 작품 글을 전부 다 읽혀야 하나요?
A. 아니요. 집 목표에 맞는 한 작품 가이드부터 고르면 됩니다.

『한국 현대시 100선』 청소년 가이드 — 한 편에서 행이 바뀌는 곳만 봐도 되나

100편이 아니라 한 편에서 행이 바뀌는 곳만 봐도 되나?

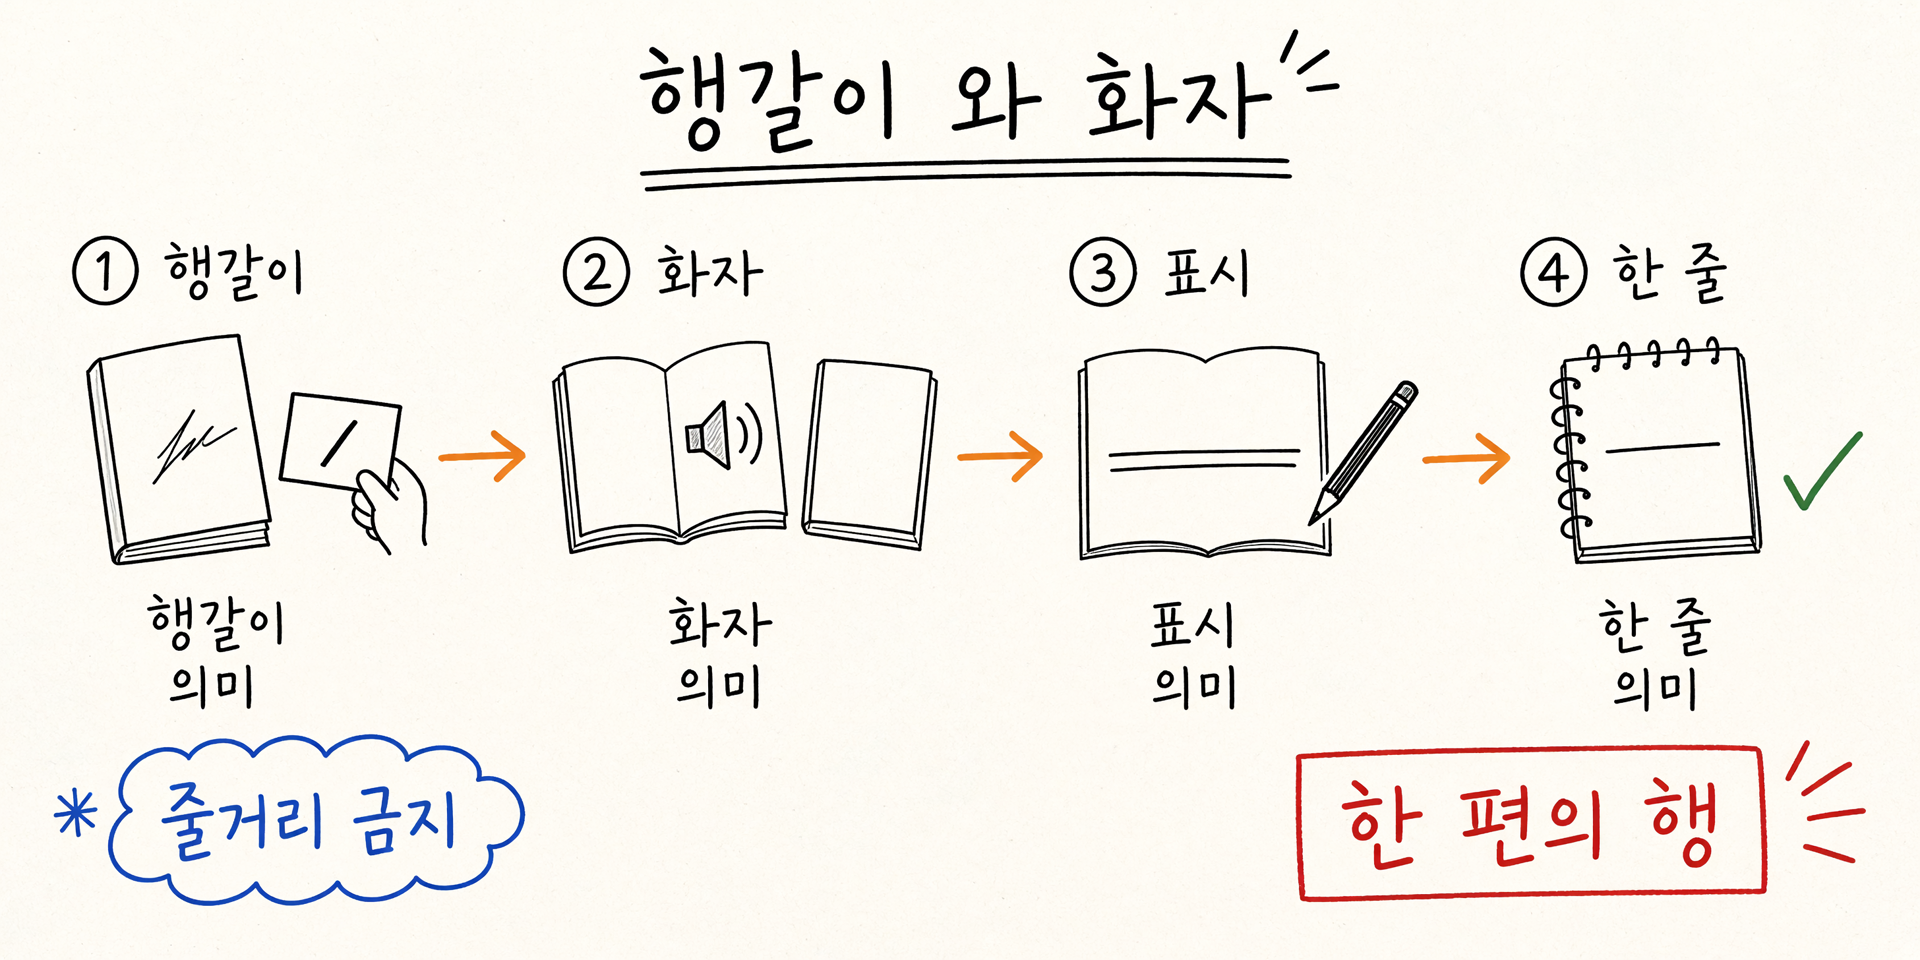
행갈이와 화자
AI로 제작한 읽기 안내 이미지

이 글의 축은 선집 완독이 아니라, 현대어 시 한 편의 비유와 행갈이를 표시하는 읽기다. 권장 대역은 중3~고이며, 『고전시가선집』의 고어·이미지 연습과 겹치지 않게 현대어·행갈이만 다룬다. 100편을 체크리스트로 밀지 않는다.

이 글을 고르는 판단 기준 3

  1. 현대시 비유·행갈이 정독을 연습할 글인지 (고전시가 고어·이미지를 찾는 집이면 고전시가 글로)
  2. 집 아이가 선집 100편 완독 압박을 받는지 (있으면 한 편으로 돌릴지)
  3. 오늘 출력이 “비유 1 + 행갈이 효과 + 한 줄”인지 (암송·100편 체크가 아닌지)

누가 맞나 · 누가 미뤄야 하나

맞을 수 있는 집 — 중3~고, 현대어 시 한 편을 10분 붙잡을 수 있는 경우, 행이 끊기는 자리를 표시할 준비된 경우

미루거나 판본을 바꿔야 하는 집 — 초등 저학년 완독 압박, 고전시가와 같은 고어 주석 방식으로만 읽으려는 경우, 100편 체크리스트로만 쓰는 경우

이 작품에서 막히는 지점

막히는 곳은 시 내용보다 선집 개수와 고전시가 습관이다. 현대시는 고어 주석보다 행갈이·비유가 리듬을 만든다. 100편을 앞에서부터 밀면 한 편의 행이 사라진다. 중학생에게는 오늘 시 한 편에서 비유가 열리는 행과 행이 끊기는 자리만 표시하는 편이 안전하다.

집에서 현대시 한 편 정독 예시

선집에서 현대어 시 한 편만 골랐다고 가정한다. 시 전문을 길게 옮기지 않는다. 고전시가 고어 주석 방식과 섞지 않는다.

  1. 10분 읽으며 표시: (비유) A가 B로 바뀌는 구절 / (행갈이) 의미가 끊기거나 미끄러지는 행 / (한 줄) 그 효과를 현대어로
  2. 질문: “오늘 시의 힘은 고어 주석인가, 행갈이가 만드는 호흡인가?”
  3. 한 줄 예: 「행갈이 — 이 현대시에서 비유가 열리는 순간, 행이 끊기는 자리가 의미의 박자를 바꾼다.」

한계 · 스포일러 경계

이 글은 100편 목록을 시험 범위처럼 외우지 않는다. 고전시가 가이드와 각도를 섞지 않는다. 시 전문을 복붙하지 않는다. 목록명·연도를 확인하기 전에는 대학 태그로 이유를 단정하지 않는다.

가정 15분 루틴 — 현대시 1편 → 비유·행갈이 표시 → 한 줄

  1. 읽기 10분 — 표시: 비유 / 행갈이
  2. 질문 1개
  3. 출력 1줄 — 비유 1 + 행갈이 효과 + 한 줄

질문 카드

  1. 오늘 시에서 비유가 열리는 구절은?
  2. 행갈이가 의미를 끊거나 미끄러뜨리는 자리는?
  3. 고전시가 방식으로 읽으면 놓치는 점은?
항목 내용
고전 번호 #027
문해력 스킬 현대시 한 편 정독(비유·행갈이)
집에서 먼저 볼 것 선집 → 현대어 시 한 편 → 비유·행갈이(고전시가와 구분)

자주 묻는 질문

Q. 고전시가선집과 같은 방법으로 읽어도 되나요?
A. 이미지 표시는 닮을 수 있으나, 여기는 고어가 아니라 현대어 비유·행갈이가 축이다. 각도를 섞지 않는다.

Q. 100편을 다 읽어야 하나요?
A. 아니다. 오늘 한 편이 단위다. 100은 선집 이름이지 숙제 개수가 아니다.

Q. 어떤 시부터 고르나요?
A. 집에 있는 판본에서 짧은 현대어 시 한 편. 암송 유명작 강제는 없다.

Q. 평론의 ‘모더니즘·이미지’ 말은 본문 언제 뒤에 보나요?
A. 시 한 편의 비유·행갈이를 표시한 뒤.

Q. 수행·세특에 쓸 때 이 선집만의 한 줄 구조는?
A. “비유 1 + 행갈이 효과 + 한 줄”. 100편 목록·암송 문장은 빼세요.

마치며

다음 단계: 시리즈 허브에서 시 정독(고전시가와 구분된 현대시) 인접을 고르세요.

시리즈: 청소년 고전 가이드 — 작품별 읽기 출발점
리드마스터 영어전문 국어논술 학원

『이중 박힌 못·단편선』 청소년 가이드 — 단편선에서 오늘 한 편만 고를 기준은

단편선에서 오늘 한 편만 고를 기준은?

한 편 고르기
AI로 제작한 읽기 안내 이미지

이 글의 축은 선집 완독이 아니라, 『이중 박힌 못』이 실린 단편선에서 오늘 한 편만 고르는 기준이다. 권장 대역은 중3~고이며, 수록작·판본이 다르면 집에 있는 목차에서 시작한다. 선집 전체를 숙제 체크로 밀지 않는다. ‘못’ 이미지가 드러나는 짧은 편을 입구로 삼을 수 있다.

이 글을 고르는 판단 기준 3

  1. 단편선에서 한 편 고르기·짧은 정독을 연습할 글인지 (장편 성장톤만 찾는 집이면 형제 글로)
  2. 집 아이 선집 두께·수위에 한 편 발췌가 필요한지
  3. 오늘 출력이 “고른 편명 1 + 고른 이유(각도) + 한 줄”인지 (선집 완독 체크가 아닌지)

누가 맞나 · 누가 미뤄야 하나

맞을 수 있는 집 — 중3~고, 목차에서 한 편을 고를 수 있는 경우, 10분 정독이 가능한 경우

미루거나 판본을 바꿔야 하는 집 — 선집 전체를 하루 숙제로 밀어붙이는 경우, 수록작 수위 확인 없이 아무 편이나 강요하는 경우

이 작품에서 막히는 지점

막히는 곳은 작품 난이도보다 선집 두께다. 단편선은 수록작마다 각도·수위가 달라, 앞에서부터 밀면 ‘못’ 한 편의 입구도 흐려진다. 중학생에게는 오늘 한 편만 고르고, 고른 이유(예: 짧은 갈등, 상징 한 가지, 대화 밀도)를 한 줄로 남기는 편이 안전하다.

집에서 단편선 한 편 고르기 예시

집에 있는 단편선 목차에서 『이중 박힌 못』 또는 오늘 읽을 한 편만 골랐다고 가정한다.

  1. 5분 목차 — 길이·수위·관심 키워드로 후보 2~3편
  2. 10분 정독 — 표시: (갈등/상징/대화 중 하나) / 질문 1 / 한 줄
  3. 질문: “오늘 이 편을 고른 기준은 길이인가, ‘못’처럼 남는 이미지인가, 대화 밀도인가?”
  4. 한 줄 예: 「고르기 — 단편선에서 오늘 『이중 박힌 못』을 고른 이유는, 못처럼 남는 이미지가 짧은 갈등 장면으로 바로 표시되기 때문이다.」

한계 · 스포일러 경계

이 글은 선집 전편 목록을 시험 범위처럼 외우지 않는다. 판본마다 수록작이 다름을 밝힌다. 목록명·연도를 확인하기 전에는 대학 태그로 이유를 단정하지 않는다.

가정 15분 루틴 — 목차에서 1편 고르기 → 정독 → 고른 이유 한 줄

  1. 목차 3분 — 후보 2~3
  2. 읽기 10분 — 한 각도 표시
  3. 출력 1줄 — 편명 + 고른 이유 + 한 줄

질문 카드

  1. 오늘 한 편을 고른 기준 세 가지 중 무엇인가?
  2. 『이중 박힌 못』에서 ‘못’이 남는 문장은?
  3. 선집 완독 없이도 되는 오늘의 출력은?
항목 내용
고전 번호 #026
문해력 스킬 단편선 고르기
집에서 먼저 볼 것 목차·수위 → 한 편 고르기 → 각도 1개 정독

자주 묻는 질문

Q. 선집을 앞에서부터 다 읽어야 하나요?
A. 아니다. 오늘 한 편이 단위다. 수록 목록은 판본마다 다르다.

Q. 『이중 박힌 못』이 없는 판본이면?
A. 같은 단편선의 다른 짧은 편을 같은 기준(한 각도)으로 고른다.

Q. 고르는 기준을 수행에 어떻게 쓰나요?
A. “편명 + 고른 이유(길이/이미지/대화) + 근거 한 줄”.

Q. 평론의 ‘단편 미학’ 말은 본문 언제 뒤에 보나요?
A. 고른 한 편 약 30%를 읽고 각도를 표시한 뒤.

Q. 수행·세특에 쓸 때 단편선만의 한 줄 구조는?
A. “고른 편 1 + 고른 이유 + 한 줄”. 선집 목차 나열은 빼세요.

마치며

다음 단계: 시리즈 허브에서 단편·선집 고르기 인접 1편을 고르세요.

시리즈: 청소년 고전 가이드 — 작품별 읽기 출발점
리드마스터 영어전문 국어논술 학원

『완득이』 청소년 가이드 — 돌봄이 잔소리가 아니라 성장 장면이 되는 한 줄을 어떻게 고르나

돌봄이 잔소리가 아니라 성장 장면이 되는 한 줄을 어떻게 고르나?

톤과 돌봄
AI로 제작한 읽기 안내 이미지

이 글의 축은 ‘웃긴 성장소설’ 요약이 아니라, 완득이를 둘러싼 돌봄이 잔소리가 아니라 성장 장면이 되는 한 줄을 고르는 읽기다. 권장 대역은 중2~고이며, 언어·폭력 수위가 부담이면 발췌한다. 훈화·교훈으로 닫지 않는다.

이 글을 고르는 판단 기준 3

  1. 성장·돌봄 톤 읽기를 연습할 작품인지 (감정 거리만 찾는 집이면 『아몬드』 글로)
  2. 집 아이 언어·폭력 수위에 발췌가 필요한지
  3. 오늘 출력이 “돌봄 장면 1 + 잔소리/성장 구분 + 한 줄”인지 (교훈 요약·웃긴 장면만 체크가 아닌지)

누가 맞나 · 누가 미뤄야 하나

맞을 수 있는 집 — 중2~고, 대화 톤에서 돌봄과 잔소리를 구분해 표시할 수 있는 경우

미루거나 판본을 바꿔야 하는 집 — 교훈 문장만 수행하는 경우, 수위 조절 전 저학년 완독 압박

이 작품에서 막히는 지점

막히는 곳은 사건보다 톤의 구분이다. 완득이 주변의 어른 말은 잔소리처럼 들려도, 같은 말이 성장을 밀어 올리는 장면이 있다. 반대로 웃긴 대사만 모으면 돌봄이 개그로 소비된다. 중학생에게는 오늘 돌봄으로 읽히는 한 줄과 그 근거 장면만 고르는 편이 안전하다.

집에서 돌봄→성장 한 줄 고르기 예시

대화가 있는 짧은 구간만 골랐다고 가정한다. 교훈으로 닫지 않는다.

  1. 10분 읽으며 표시: (잔소리처럼 들림) / (그래도 돌봄인 근거) / (완득이의 반응)
  2. 질문: “이 한 줄은 훈화인가, 완득이가 한 걸음 움직이는 장면인가?”
  3. 한 줄 예: 「돌봄 — 완득이에게 남는 이 한 줄은 잔소리의 형태를 띠지만, 그가 실제로 움직이는 성장 장면이 된다.」

한계 · 스포일러 경계

이 글은 결말을 교훈으로 요약하지 않는다. 수위가 높은 언어는 길게 인용하지 않는다. 목록명·연도를 확인하기 전에는 대학 태그로 이유를 단정하지 않는다.

가정 15분 루틴 — 대화 발췌 → 돌봄/잔소리 구분 → 성장 한 줄

  1. 읽기 10분 — 표시: 잔소리처럼 들림 / 돌봄 근거 / 반응
  2. 질문 1개
  3. 출력 1줄 — 돌봄 장면 1 + 구분 + 한 줄

질문 카드

  1. 잔소리처럼 들리지만 돌봄인 대사는?
  2. 완득이가 그 말에 실제로 반응하는 지점은?
  3. 교훈으로 바꾸면 사라지는 톤은?
항목 내용
고전 번호 #025
문해력 스킬 성장·돌봄 톤
집에서 먼저 볼 것 발췌 → 돌봄 대화 → 잔소리/성장 구분 한 줄

자주 묻는 질문

Q. 웃긴 장면만 골라도 되나요?
A. 웃음은 가능하나, 돌봄이 성장으로 바뀌는 한 줄이 축이다.

Q. 중2가 바로 읽어도 되나요?
A. 중2~ 가능하다. 언어 수위가 부담이면 그 구간을 건너뛴다.

Q. 선생님·보호자 역할을 현실에 대입해도 되나요?
A. 대입은 조심한다. 텍스트의 톤 표시가 먼저다.

Q. 평론의 ‘성장·돌봄’ 말은 본문 언제 뒤에 보나요?
A. 『완득이』 발췌 약 30%를 읽고 돌봄/잔소리 구분을 표시한 뒤.

Q. 수행·세특에 쓸 때 『완득이』만의 한 줄 구조는?
A. “돌봄 장면 1 + 잔소리/성장 구분 + 한 줄”. 교훈 요약만 쓰지 마세요.

마치며

다음 단계: 시리즈 허브에서 청소년 소설·성장 톤 인접 1편을 고르세요.

시리즈: 청소년 고전 가이드 — 작품별 읽기 출발점
리드마스터 영어전문 국어논술 학원

『아몬드』 청소년 가이드 — 감정을 못 읽는 주인공을 공감 숙제로 내면 왜 어긋나나

감정을 못 읽는 주인공을 공감 숙제로 내면 왜 어긋나나?

거리와 감정
AI로 제작한 읽기 안내 이미지

이 글의 축은 줄거리·장애 라벨이 아니라, 윤재가 감정을 읽는 방식과 독자가 두는 거리를 표시하는 읽기다. 권장 대역은 중3~고이며, 폭력 수위가 부담이면 발췌·건너뛰기를 정한다. ‘감동’으로만 닫지 않는다.

이 글을 고르는 판단 기준 3

  1. 감정 읽기·거리 두기를 연습할 작품인지 (역사 증언을 찾는 집이면 『소년이 온다』 글로)
  2. 집 아이 폭력·감정 수위에 발췌가 필요한지
  3. 오늘 출력이 “윤재의 감정 읽기 장면 1 + 내 거리 + 한 줄”인지 (진단 라벨·감동 요약이 아닌지)

누가 맞나 · 누가 미뤄야 하나

맞을 수 있는 집 — 중3~고, 화자의 감정 처리와 내 반응을 구분해 적을 수 있는 경우

미루거나 판본을 바꿔야 하는 집 — 폭력 수위 조절 전, 인물을 진단명으로만 읽으려는 경우, 감동 문장만 수행하는 경우

이 작품에서 막히는 지점

막히는 곳은 사건보다 라벨과 동일시다. 윤재가 감정을 ‘못 읽는다’고 해서, 독자가 그를 설명서로 대체하면 장면이 사라진다. 반대로 감정 이입을 강요하면 거리가 무너진다. 청소년에게는 오늘 윤재가 감정을 처리하는 문장과 내가 동의하지 않거나 조심하는 한 줄을 나란히 적는 편이 안전하다.

집에서 감정 읽기 거리 표시 예시

수위가 높은 구간은 건너뛰었다고 가정한다. 진단·라벨 문장을 길게 쓰지 않는다.

  1. 10분 읽으며 표시: (읽기) 윤재가 표정·말을 해석하는 방식 / (반응) 주변이 그를 다루는 말 / (거리) 내가 그 장면에 두는 한 줄
  2. 질문: “이 장면에서 문제는 윤재의 ‘결핍’인가, 감정을 요구하는 바깥의 말인가?”
  3. 한 줄 예: 「거리 — 윤재가 감정을 천천히 읽는 문장 옆에서, 나는 그를 진단하지 않고 그 속도를 표시만 한다.」

한계 · 스포일러 경계

이 글은 의학 진단을 단정하지 않는다. 폭력 장면을 길게 인용하지 않는다. 감동 클리셰로 거리를 지우지 않는다. 목록명·연도를 확인하기 전에는 대학 태그로 이유를 단정하지 않는다.

가정 15분 루틴 — 감정 읽기 장면 → 거리 한 줄 표시

  1. 읽기 10분 — 표시: 윤재의 읽기 / 바깥의 말 / 내 거리
  2. 질문 1개
  3. 출력 1줄 — 장면 1 + 거리 + 한 줄

질문 카드

  1. 윤재가 감정을 해석하는 문장은 어디인가?
  2. 바깥이 감정을 요구·단정하는 말은?
  3. 내가 라벨 없이 남긴 거리 한 줄은?
항목 내용
고전 번호 #024
문해력 스킬 감정 읽기 거리
집에서 먼저 볼 것 수위 → 발췌 → 윤재의 감정 읽기 / 내 거리 표시

자주 묻는 질문

Q. 인물을 장애·진단으로 먼저 설명해도 되나요?
A. 권하지 않는다. 장면의 감정 읽기 방식을 먼저 표시한다.

Q. 폭력 장면은 건너뛰어도 되나요?
A. 된다. 남은 문장에서 윤재의 읽기 방식만 표시한다.

Q. 감동적으로 읽어도 되나요?
A. 감정은 가능하나, 감동 문장으로 거리 표시를 대체하지 않는다.

Q. 평론의 ‘공감·차이’ 말은 본문 언제 뒤에 보나요?
A. 『아몬드』 발췌 약 30%를 읽고 윤재의 읽기·거리를 표시한 뒤.

Q. 수행·세특에 쓸 때 『아몬드』만의 한 줄 구조는?
A. “감정 읽기 장면 1 + 내 거리 + 한 줄”. 진단 라벨·감동 요약만 쓰지 마세요.

마치며

다음 단계: 시리즈 허브에서 현대 청소년 소설·거리 축 인접 1편을 고르세요.

시리즈: 청소년 고전 가이드 — 작품별 읽기 출발점
리드마스터 영어전문 국어논술 학원